找回密码
 立即注册
搜索

[开发] 看完这篇还不懂高并发中的线程与线程池你来打我(内含20张图)

[复制链接]
智慧谋略 发表于 2024-3-12 12:09:12 | 显示全部楼层 |阅读模式
  
            一切要从CPU说起         


      你可能会有疑问,讲多线程为什么要从CPU说起呢?原因很简单,       在这里没有那些时髦的概念,你可以更加清晰的看清问题的本质      。  
      CPU并不知道线程、进程之类的概念。  
      CPU只知道两件事:  
      1. 从内存中取出指令  
      2. 执行指令,然后回到1  

   6f8e1b4a-a499-11ee-bfb4-00163e2e672a.png

      你看,在这里CPU确实是不知道什么进程、线程之类的概念。  
      接下来的问题就是CPU从哪里取出指令呢?答案是来自一个被称为Program Counter(简称PC)的寄存器,也就是我们熟知的程序计数器,在这里大家不要把寄存器想的太神秘,你可以简单的把寄存器理解为内存,只不过存取速度更快而已。  
      PC寄存器中存放的是什么呢?这里存放的是指令在内存中的地址,什么指令呢?是CPU将要执行的下一条指令。  
   6fade6f0-a499-11ee-bfb4-00163e2e672a.png

      那么是谁来设置PC寄存器中的指令地址呢?  
      原来PC寄存器中的地址默认是自动加1的,这当然是有道理的,因为大部分情况下CPU都是一条接一条顺序执行,当遇到if、else时,这种顺序执行就被打破了,CPU在执行这类指令时会根据计算结果来动态改变PC寄存器中的值,这样CPU就可以正确的跳转到需要执行的指令了。  
      聪明的你一定会问,那么PC中的初始值是怎么被设置的呢?  
      在回答这个问题之前我们需要知道CPU执行的指令来自哪里?是来自内存,废话,内存中的指令是从磁盘中保存的可执行程序加载过来的,磁盘中可执行程序是编译器生成的,编译器又是从哪里生成的机器指令呢?答案就是       我们定义的函数      。  
   6fce58ea-a499-11ee-bfb4-00163e2e672a.png


      注意是函数,       函数被编译后才会形成CPU执行的指令      ,那么很自然的,我们该如何让CPU执行一个函数呢?显然我们只需要找到函数被编译后形成的第一条指令就可以了,第一条指令就是函数入口。  
      现在你应该知道了吧,我们想要CPU执行一个函数,那么       只需要把该函数对应的第一条机器指令的地址写入PC寄存器就可以了      ,这样我们写的函数就开始被CPU执行起来啦。  
      你可能会有疑问,这和线程有什么关系呢?  


            从CPU到操作系统         


      上一小节中我们明白了CPU的工作原理,我们想让CPU执行某个函数,那么只需要把函数对应的第一条机器执行装入PC寄存器就可以了,       这样即使没有操作系统我们也可以让CPU执行程序      ,虽然可行但这是一个非常繁琐的过程,我们需要:  
  •             在内存中找到一块大小合适的区域装入程序   
  •             找到函数入口,设置好PC寄存器让CPU开始执行程序   
      这两个步骤绝不是那么容易的事情,如果每次在执行程序时程序员自己手动实现上述两个过程会疯掉的,因此聪明的程序员就会想干脆直接写个程序来自动完成上面两个步骤吧。  
   6ff470ac-a499-11ee-bfb4-00163e2e672a.png

      机器指令需要加载到内存中执行,因此需要记录下内存的起始地址和长度;同时要找到函数的入口地址并写到PC寄存器中,想一想这是不是需要一个数据结构来记录下这些信息:

  1. struct *** {
  2.    void* start_addr;
  3.    int len;
  4.    
  5.    void* start_point;
  6.    ...
  7. };
复制代码

     接下来就是起名字时刻。  
      这个数据结构总要有个名字吧,这个结构体用来记录什么信息呢?记录的是程序在被加载到内存中的运行状态,程序从磁盘加载到内存跑起来叫什么好呢?干脆就叫       进程(Process)      好了,我们的指导原则就是一定要听上去比较神秘,总之大家都不容易弄懂就对了,我将其称为“       弄不懂原则      ”。  
      就这样进程诞生了。  
      CPU执行的第一个函数也起个名字,第一个要被执行的函数听起来比较重要,干脆就叫       main函数      吧。  
      完成上述两个步骤的程序也要起个名字,根据“弄不懂原则”这个“简单”的程序就叫       操作系统      (Operating System)好啦。  
      就这样操作系统诞生了,程序员要想运行程序再也不用自己手动加载一遍了。  
      现在进程和操作系统都有了,一切看上去都很完美。  

  
            从单核到多核,如何充分利用多核         


      人类的一大特点就是生命不息折腾不止,从单核折腾到了多核。  
   700c4b46-a499-11ee-bfb4-00163e2e672a.jpg

      这时,假设我们想写一个程序并且要分利用多核该怎么办呢?  
      有的同学可能会说不是有进程吗,多开几个进程不就可以了?听上去似乎很有道理,但是主要存在这样几个问题:  
  •             进程是需要占用内存空间的(从上一节能看到这一点),如果多个进程基于同一个可执行程序,那么这些进程其内存区域中的内容几乎完全相同,这显然会造成内存的浪费   
  •             计算机处理的任务可能是比较复杂的,这就涉及到了进程间通信,由于各个进程处于不同的内存地址空间,进程间通信天然需要借助操作系统,这就在增大编程难度的同时也增加了系统开销   
      该怎么办呢?  


            从进程到线程         


      让我再来仔细的想一想这个问题,所谓进程无非就是内存中的一段区域,这段区域中保存了       CPU执行的机器指令以及函数运行时的堆栈信息      ,要想让进程运行,就把main函数的第一条机器指令地址写入PC寄存器,这样进程就运行起来了。  
   702c8f64-a499-11ee-bfb4-00163e2e672a.png


      进程的缺点在于只有一个入口函数,也就是main函数,因此进程中的机器指令       只能被一个CPU执行      ,那么有没有办法让多个CPU来执行同一个进程中的机器指令呢?  
      聪明的你应该能想到,既然我们可以把main函数的第一条指令地址写入PC寄存器,那么其它函数和main函数又有什么区别呢?  
      答案是没什么区别,main函数的特殊之处无非就在于是CPU执行的第一个函数,除此之外再无特别之处,       我们可以把PC寄存器指向main函数,就可以把PC寄存器指向任何一个函数      。  
          当我们把PC寄存器指向非main函数时,线程就诞生了      。  

   704a673c-a499-11ee-bfb4-00163e2e672a.png


      至此我们解放了思想,一个进程内可以有多个入口函数,       也就是说属于同一个进程中的机器指令可以被多个CPU同时执行      。  
      注意,这是一个和进程不同的概念,创建进程时我们需要在内存中找到一块合适的区域以装入进程,然后把CPU的PC寄存器指向main函数,也就是说进程中只有一个       执行流      。  
   7068a904-a499-11ee-bfb4-00163e2e672a.png

      但是现在不一样了,多个CPU可以在同一个屋檐下(进程占用的内存区域)同时执行属于该进程的多个入口函数,也就是说现在一个进程内可以有       多个执行流      了。  
   707e6bfe-a499-11ee-bfb4-00163e2e672a.png

      总是叫执行流好像有点太容易理解了,再次祭出”弄不懂原则“,起个不容易懂的名字,就叫线程吧。  
      这就是线程的由来。  
      操作系统为每个进程维护了一堆信息,用来记录进程所处的内存空间等,这堆信息记为数据集A。  
      同样的,操作系统也需要为线程维护一堆信息,用来记录线程的入口函数或者栈信息等,这堆数据记为数据集B。  
      显然数据集B要比数据A的量要少,同时不像进程,创建一个线程时无需去内存中找一段内存空间,       因为线程是运行在所处进程的地址空间的      ,这块地址空间在程序启动时已经创建完毕,同时线程是程序在运行期间创建的(进程启动后),因此当线程开始运行的时候这块地址空间就已经存在了,线程可以直接使用。这就是为什么各种教材上提的创建线程要比创建进程快的原因(当然还有其它原因)。  
      值得注意的是,有了线程这个概念后,我们只需要进程开启后创建多个线程就可以让所有CPU都忙起来,       这就是所谓高性能、高并发的根本所在      。  
   70944d16-a499-11ee-bfb4-00163e2e672a.jpg

      很简单,只需要创建出数量       合适      的线程就可以了。  
      另外值得注意的一点是,由于各个线程共享进程的内存地址空间,因此线程之间的通信无需借助操作系统,这给程序员带来极大方便的同时也带来了无尽的麻烦,多线程遇到的多数问题都出自于线程间通信简直太方便了以至于非常容易出错。       出错的根源在于CPU执行指令时根本没有线程的概念,      多线程编程面临的       互斥      与       同步      问题需要程序员自己解决,关于互斥与同步问题限于篇幅就不详细展开了,大部分的操作系统资料都有详细讲解。  
      最后需要提醒的是,虽然前面关于线程讲解使用的图中用了多个CPU,但不是说一定要有多核才能使用多线程,在单核的情况下一样可以创建出多个线程,       原因在于线程是操作系统层面的实现,和有多少个核心是没有关系的      ,CPU在执行机器指令时也意识不到执行的机器指令属于哪个线程。即使在只有一个CPU的情况下,操作系统也可以通过线程调度让各个线程“同时”向前推进,方法就是将CPU的时间片在各个线程之间来回分配,这样多个线程看起来就是“同时”运行了,但实际上任意时刻还是只有一个线程在运行。  


            线程与内存         


      在前面的讨论中我们知道了线程和CPU的关系,也就是把CPU的PC寄存器指向线程的入口函数,这样线程就可以运行起来了,这就是为什么我们创建线程时必须指定一个入口函数的原因。无论使用任何编程语言,创建一个线程大体相同:


  1. // 设置线程入口函数DoSomething
  2. thread = CreateThread(DoSomething);

  3. // 让线程运行起来
  4. thread.Run();

复制代码

     那么线程和内存又有什么关联呢?  
      我们知道函数在被执行的时产生的数据包括       函数参数      、       局部变量      、       返回地址      等信息,这些信息是保存在栈中的,线程这个概念还没有出现时进程中只有一个执行流,因此只有一个栈,这个栈的栈底就是进程的入口函数,也就是main函数,假设main函数调用了funA,funcA又调用了funcB,如图所示:  
   70b4bd12-a499-11ee-bfb4-00163e2e672a.png

      那么有了线程以后了呢?  
      有了线程以后一个进程中就存在多个执行入口,即同时存在多个执行流,那么只有一个执行流的进程需要一个栈来保存运行时信息,那么很显然有多个执行流时就需要有多个栈来保存各个执行流的信息,也就是说       操作系统要为每个线程在进程的地址空间中分配一个栈      ,即每个线程都有独属于自己的栈,能意识到这一点是极其关键的。  
   70ce71a8-a499-11ee-bfb4-00163e2e672a.png


      同时我们也可以看到,创建线程是要消耗进程内存空间的,这一点也值得注意。   


            线程的使用         


      现在有了线程的概念,那么接下来作为程序员我们该如何使用线程呢?  
      从生命周期的角度讲,线程要处理的任务有两类:长任务和短任务。  
          1,长任务,long-lived tasks     
      顾名思义,就是任务存活的时间很长,比如以我们常用的word为例,我们在word中编辑的文字需要保存在磁盘上,往磁盘上写数据就是一个任务,那么这时一个比较好的方法就是专门创建一个写磁盘的线程,该写线程的生命周期和word进程是一样的,只要打开word就要创建出该写线程,当用户关闭word时该线程才会被销毁,这就是长任务。  
   70f6a826-a499-11ee-bfb4-00163e2e672a.png

      这种场景非常适合创建专用的线程来处理某些特定任务,这种情况比较简单。  
      有长任务,相应的就有短任务。  

          2,短任务,short-lived tasks     
      这个概念也很简单,那就是任务的处理时间很短,比如一次网络请求、一次数据库查询等,这种任务可以在短时间内快速处理完成。因此短任务多见于各种Server,像web server、database server、file server、mail server等,这也是互联网行业的同学最常见的场景,这种场景是我们要重点讨论的。  
      这种场景有两个特点:一个是       任务处理所需时间短      ;另一个是       任务数量巨大      。  
      如果让你来处理这种类型的任务该怎么办呢?  
      你可能会想,这很简单啊,当server接收到一个请求后就创建一个线程来处理任务,处理完成后销毁该线程即可,So easy。  
      这种方法通常被称为thread-per-request,也就是说来一个请求就创建一个线程:  
   71281712-a499-11ee-bfb4-00163e2e672a.png

      如果是长任务,那么这种方法可以工作的很好,但是对于大量的短任务这种方法虽然实现简单但是有这样几个缺点:  
      1. 从前几节我们能看到,线程是操作系统中的概念(这里不讨论用户态线程实现、协程之类),因此创建线程天然需要借助操作系统来完成,操作系统创建和销毁线程是需要消耗时间的  
      2. 每个线程需要有自己独立的栈,因此当创建大量线程时会消耗过多的内存等系统资源  
      这就好比你是一个工厂老板(想想都很开心有没有),手里有很多订单,每来一批订单就要招一批工人,生产的产品非常简单,工人们很快就能处理完,处理完这批订单后就把这些千辛万苦招过来的工人辞退掉,当有新的订单时你再千辛万苦的招一遍工人,干活儿5分钟招人10小时,如果你不是励志要让企业倒闭的话大概是不会这么做到的,因此一个更好的策略就是招一批人后就地养着,有订单时处理订单,没有订单时大家可以闲呆着。  
   714e4d92-a499-11ee-bfb4-00163e2e672a.jpg

      这就是线程池的由来。   


            从多线程到线程池         


      线程池的概念是非常简单的,无非就是创建一批线程,之后就不再释放了,有任务就提交给这些线程处理,因此无需频繁的创建、销毁线程,同时由于线程池中的线程个数通常是固定的,也不会消耗过多的内存,因此这里的思想就是       复用、可控      。  


            线程池是如何工作的         


      可能有的同学会问,该怎么给线程池提交任务呢?这些任务又是怎么给到线程池中线程呢?  
      很显然,数据结构中的队列天然适合这种场景,提交任务的就是生产者,消费任务的线程就是消费者,实际上这就是经典的       生产者-消费者问题      。  
   71733738-a499-11ee-bfb4-00163e2e672a.png

      现在你应该知道为什么操作系统课程要讲、面试要问这个问题了吧,因为如果你对生产者-消费者问题不理解的话,本质上你是无法正确的写出线程池的。  
      限于篇幅在这里博主不打算详细的讲解生产者消费者问题,参考操作系统相关资料就能获取答案。这里博主打算讲一讲一般提交给线程池的任务是什么样子的。  
      一般来说提交给线程池的任务包含两部分:1)       需要被处理的数据      ;2)       处理数据的函数


  1. struct task {
  2. void* data;     // 任务所携带的数据
  3.     handler handle; // 处理数据的方法
  4. }

复制代码

     (注意,你也可以把代码中的struct理解成class,也就是对象。)  
      线程池中的线程会阻塞在队列上,当生产者向队列中写入数据后,线程池中的某个线程会被唤醒,该线程从队列中取出上述结构体(或者对象),以结构体       (或者对象)      中的数据为参数并调用处理函数:

  1. while(true) {  struct task = GetFromQueue(); // 从队列中取出数据  task->handle(task->data);     // 处理数据}
复制代码

     以上就是线程池最       核心      的部分。  
      理解这些你就能明白线程池是如何工作的了。  

  
            线程池中线程的数量         


      现在线程池有了,那么线程池中线程的数量该是多少呢?  
      在接着往下看前先自己想一想这个问题。  
      如果你能看到这里说明还没有睡着。  
      要知道线程池的线程过少就不能充分利用CPU,线程创建的过多反而会造成系统性能下降,内存占用过多,线程切换造成的消耗等等。因此线程的数量既不能太多也不能太少,那到底该是多少呢?  
      回答这个问题,你需要知道线程池处理的任务有哪几类,有的同学可能会说你不是说有两类吗?长任务和短任务,这个是从生命周期的角度来看的,那么从处理任务所需要的资源角度看也有两种类型,CPU密集型和I/O密集型。             1,CPU密集型     
      所谓CPU密集型就是说处理任务不需要依赖外部I/O,比如科学计算、矩阵运算等等。在这种情况下只要线程的数量和核数基本相同就可以充分利用CPU资源。  
   7192da5c-a499-11ee-bfb4-00163e2e672a.png


          2,I/O密集型     
      这一类任务可能计算部分所占用时间不多,大部分时间都用在了比如磁盘I/O、网络I/O等。  
   71a6a1d6-a499-11ee-bfb4-00163e2e672a.png

      这种情况下就稍微复杂一些了,你需要利用性能测试工具评估出用在I/O等待上的时间,这里记为WT(wait time),以及CPU计算所需要的时间,这里记为CT(computing time),那么对于一个N核的系统,合适的线程数大概是N * (1 + WT/CT),假设I/O等待时间和计算时间相同,那么你大概需要2N个线程才能充分利用CPU资源,注意这只是一个理论值,具体设置多少需要根据真实的业务场景进行测试。  
      当然充分利用CPU不是唯一需要考虑的点,随着线程数量的增多,内存占用、系统调度、打开的文件数量、打开的socker数量以及打开的数据库链接等等是都需要考虑的。  
      因此这里没有万能公式,要       具体情况具体分析      。

  
            线程池不是万能的         


      线程池仅仅是多线程的一种使用形式,因此多线程面临的问题线程池同样不能避免,像死锁问题、race condition问题等等,关于这一部分同样可以参考操作系统相关资料就能得到答案,所以基础很重要呀老铁们。  


            线程池使用的最佳实践         


      线程池是程序员手中强大的武器,互联网公司的各个server上几乎都能见到线程池的身影,使用线程池前你需要考虑:  
  •             充分理解你的任务,是长任务还是短任务、是CPU密集型还是I/O密集型,如果两种都有,那么一种可能更好的办法是把这两类任务放到不同的线程池中,这样也许可以更好的确定线程数量   
  •             如果线程池中的任务有I/O操作,那么务必对此任务设置超时,否则处理该任务的线程可能会一直阻塞下去   
  •             线程池中的任务最好不要           同步          等待其它任务的结果   


            总结         


      本节我们从CPU开始一路来到常用的线程池,从底层到上层、从硬件到软件。注意,这里通篇没有出现任何特定的编程语言,线程不是语言层面的概念(依然不考虑用户态线程),但是当你真正理解了线程后,相信你可以在任何一门语言下用好多线程,你需要理解的是道,此后才是术。  
      希望这篇文章对大家理解线程以及线程池有所帮助。  


 楼主| 智慧谋略 发表于 2024-3-12 12:18:19 | 显示全部楼层
读取文件时,程序经历了什么?
你有没有想过当我们执行I/O操作时计算机底层都发生了些什么?
在回答这个问题之前,我们先来看下为什么对于计算机来说I/O是极其重要的。
不能执行I/O的计算机是什么?
相信对于程序员来说I/O操作是最为熟悉不过的了:
当我们使用C语言中的printf、C++中的"<<",Python中的print,Java中的System.out.println等时,这是I/O;当我们使用各种语言读写文件时,这也是I/O;当我们通过TCP/IP进行网络通信时,这同样是I/O;当我们使用鼠标龙飞凤舞时,当我们扛起键盘在评论区里指点江山亦或是埋头苦干努力制造bug时、当我们能看到屏幕上的漂亮的图形界面时等等,这一切都是I/O。
想一想,如果没有I/O计算机该是一种多么枯燥的设备,不能看电影、不能玩游戏,也不能上网,这样的计算机最多就是一个大号的计算器。
既然I/O这么重要,那么到底什么才是I/O呢?

什么是I/O
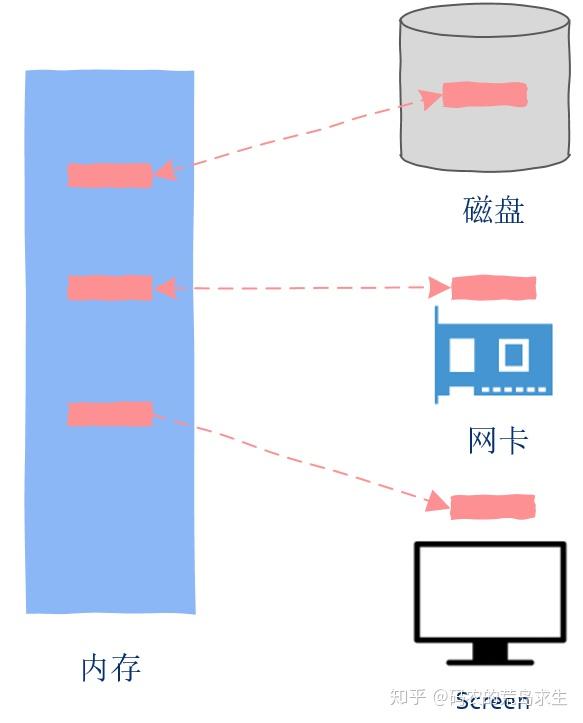
I/O就是简单的数据Copy,仅此而已。

如果数据是从外部设备copy到内存中,这就是Input。
如果数据是从内存copy到外部设备,这就是Output。
内存与外部设备之间不嫌麻烦的来回copy数据就是Input and Output,简称I/O(Input/Output),仅此而已。

I/O与CPU
现在我们知道了什么是I/O,接下来就是重点部分了,大家注意,坐稳了。
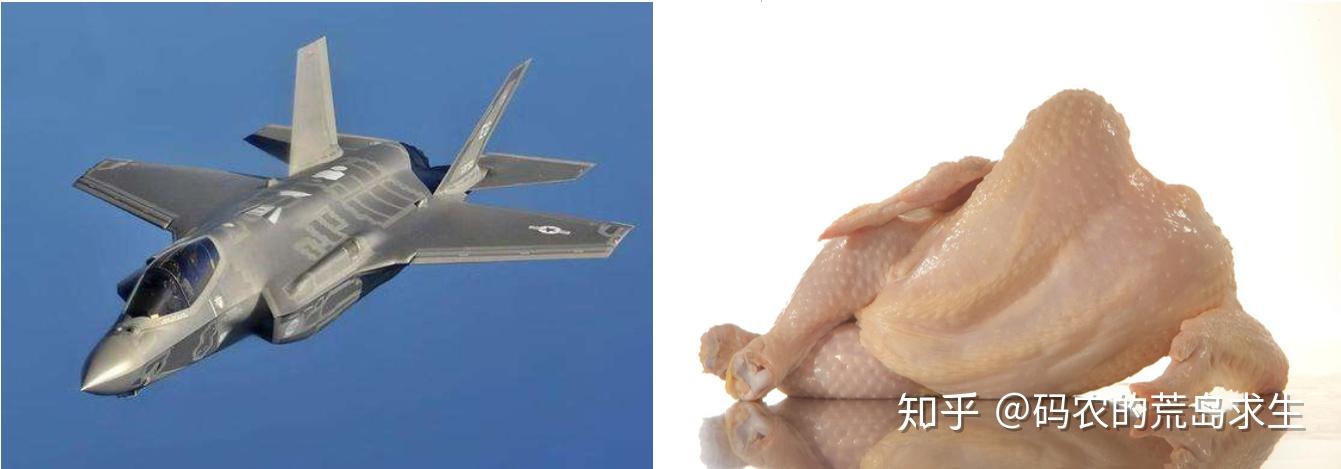
我们知道现在的CPU其主频都是数GHz起步,这是什么意思呢?简单说就是CPU执行机器指令的速度是纳秒级别的,而通常的I/O比如磁盘操作,一次磁盘seek大概在毫秒级别,因此如果我们把CPU的速度比作战斗机的话,那么I/O操作的速度就是肯德鸡


也就是说当我们的程序跑起来时(CPU执行机器指令),其速度是要远远快于I/O速度的,那么接下来的问题就是二者速度相差这么大,那么我们该如何设计、该如何更加合理的高效利用系统资源呢?
既然有速度差异,而且进程在执行完I/O操作前不能继续向前推进,那么显然只有一个办法,那就是等待,wait

此这里的关键点就是快递没到前手头上的事情可以先暂停,切换到其它任务,等快递过来了再切换回来
理解了这一点你就能明白执行I/O操作时底层都发生了什么。
接下来让我们以读取磁盘文件为例来讲解这一过程。
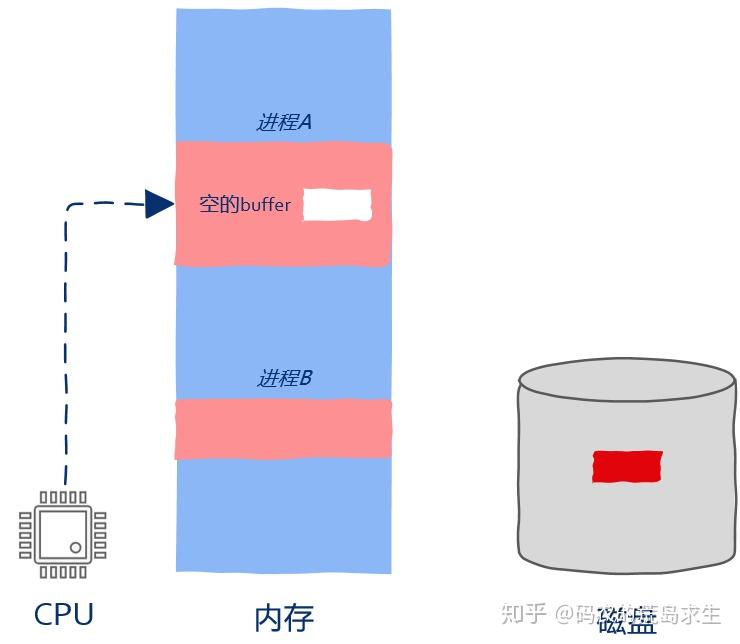
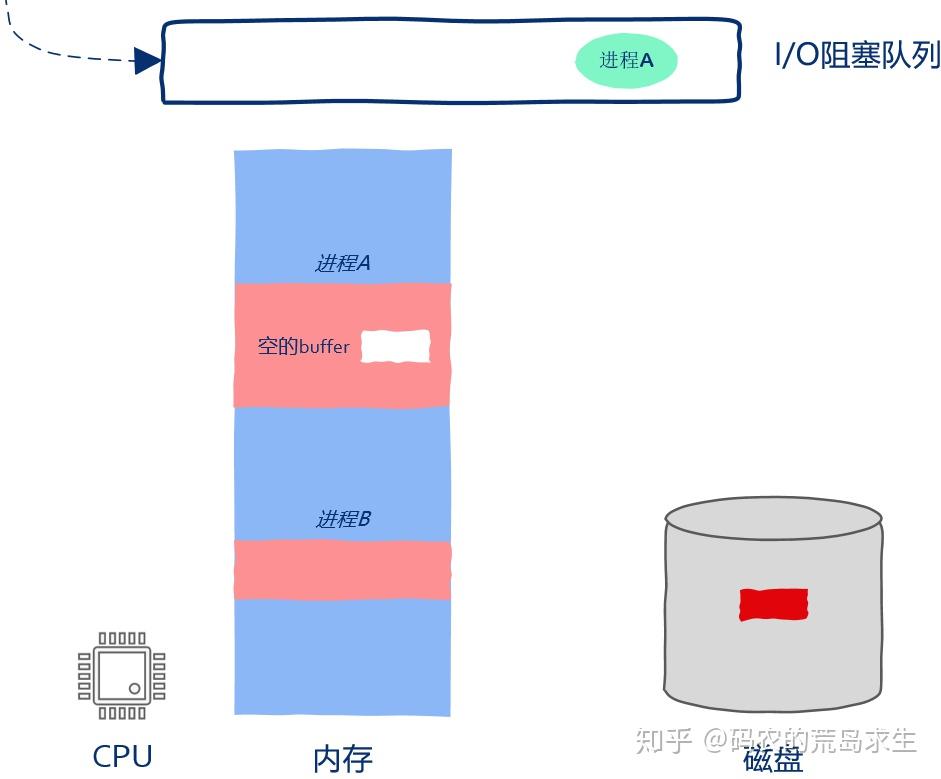
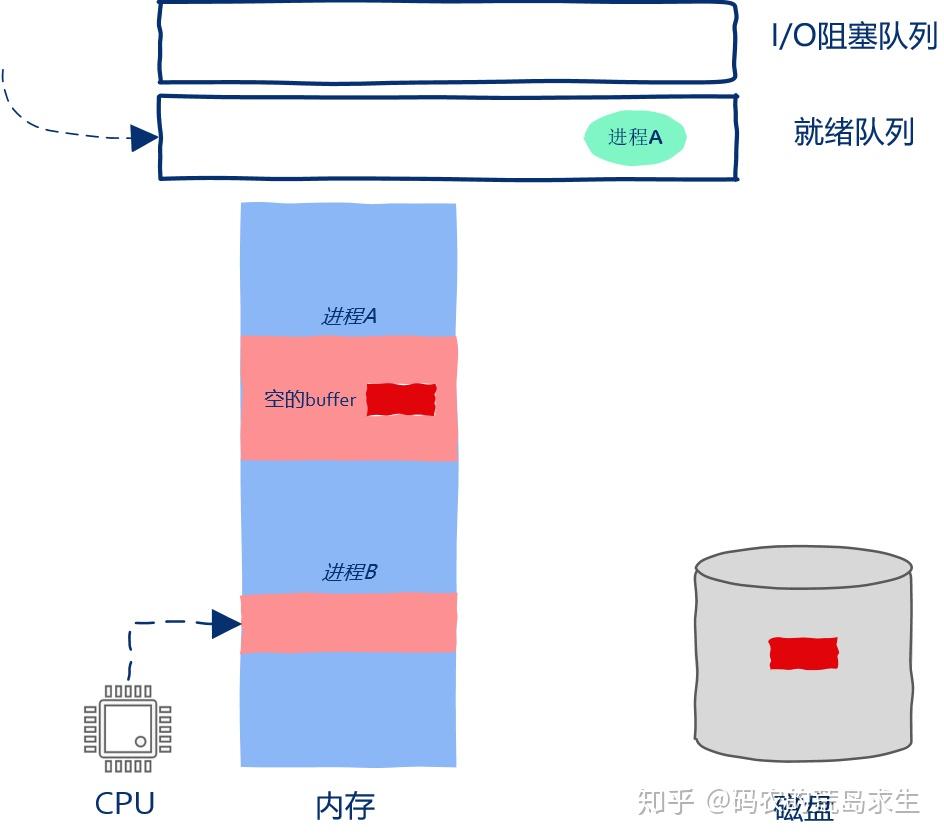
现在内存中有两个进程,进程A和进程B,当前进程A正在运行,如图所示:


进程A中有一段读取文件的代码,不管在什么语言中通常我们定义一个用来装数据的buff,然后调用read之类的函数,像这样:
  1. read(buff);
复制代码

这就是一种典型的I/O操作,当CPU执行到这段代码的时候会向磁盘发送读取请求,注意与CPU执行指令的速度相比,I/O操作操作是非常慢的,因此操作系统是不可能把宝贵的CPU计算资源浪费在无谓的等待上的,这时重点来了,注意接下来是重点哦。
由于外部设备执行I/O操作是相当慢的,因此在I/O操作完成之前进程是无法继续向前推进的,这就是所谓的阻塞,即通常所说的block。操作系统检测到进程向I/O设备发起请求后就暂停进程的运行,怎么暂停运行呢?很简单,只需要记录下当前进程的运行状态并把CPU的PC寄存器指向其它进程的指令就可以了。
进程有暂停就会有继续执行,因此操作系统必须保存被暂停的进程以备后续继续执行,显然我们可以用队列来保存被暂停执行的进程,如图所示,进程A被暂停执行并被放到阻塞队列中(注意,不同的操作系统会有不同的实现,可能每个I/O设备都有一个对应的阻塞队列,但这种实现细节上的差异不影响我们的讨论)。


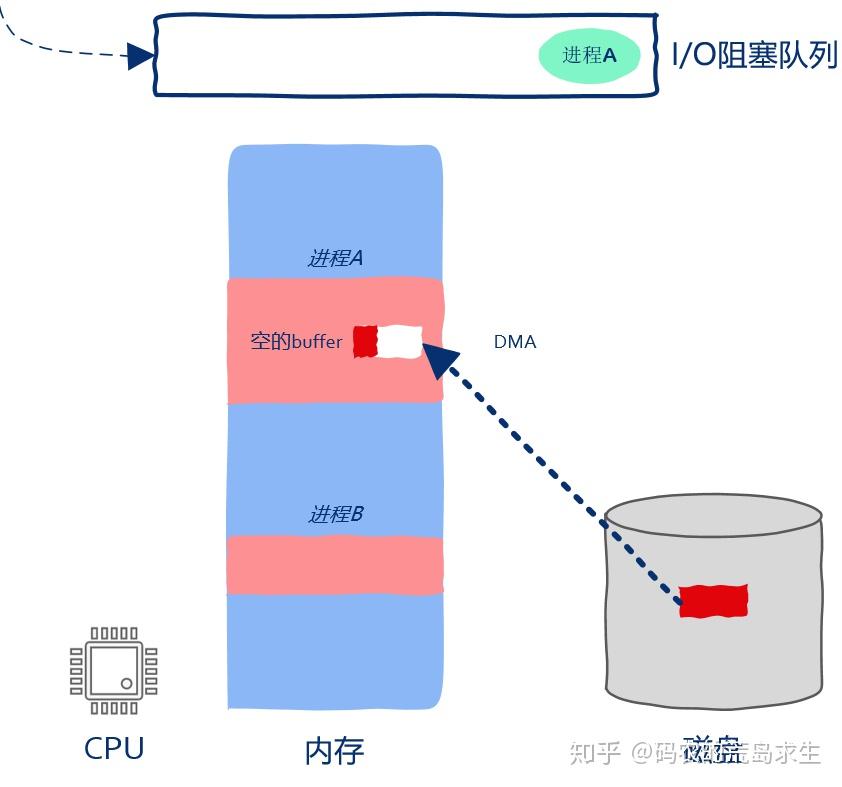
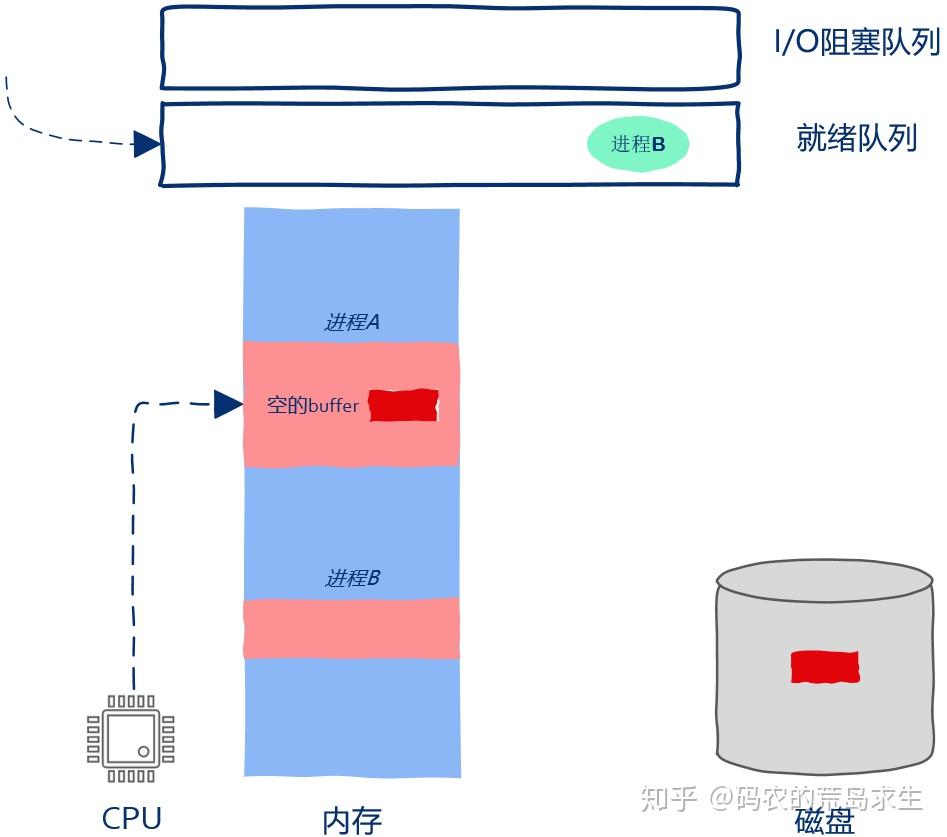
这时操作系统已经向磁盘发送了I/O请求,因此磁盘driver开始将磁盘中的数据copy到进程A的buff中,虽然这时进程A已经被暂停执行了,但这并不妨碍磁盘向内存中copy数据。注意,现代磁盘向内存copy数据时无需借助CPU的帮助,这就是所谓的DMA(Direct Memory Access),这个过程如图所示:


让磁盘先copy着数据,我们接着聊。
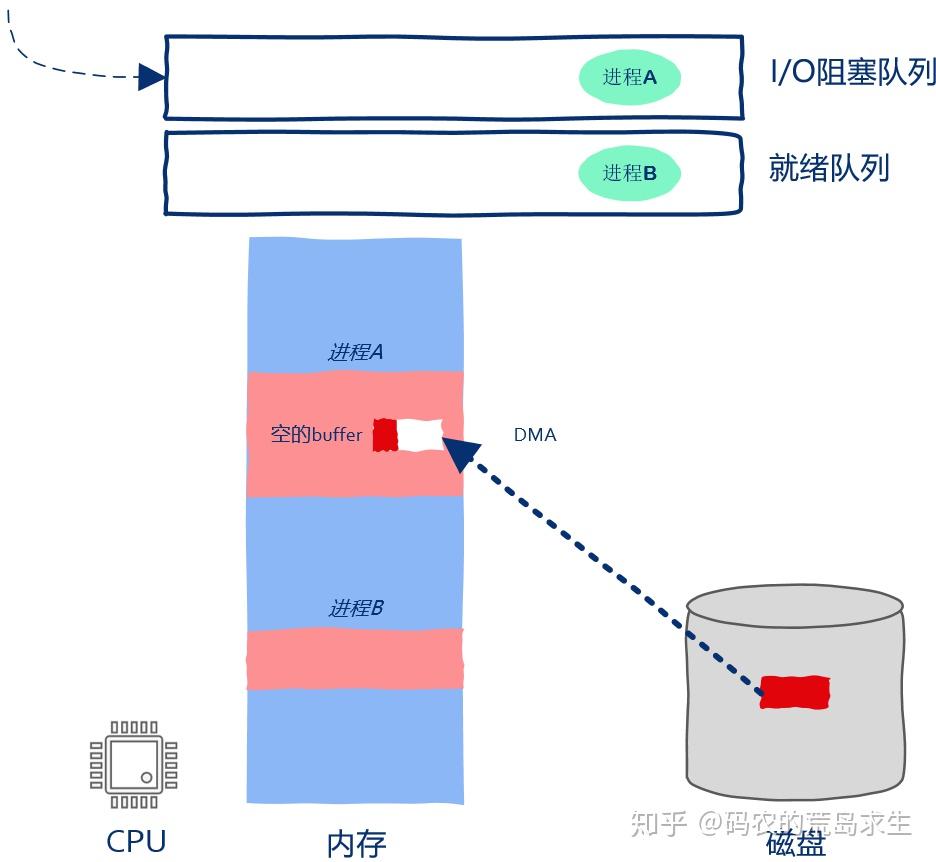
实际上操作系统中除了有阻塞队列之外也有就绪队列,所谓就绪队列是指队列里的进程准备就绪可以被CPU执行了,你可能会问为什么不直接执行非要有个就绪队列呢?答案很简单,那就是僧多粥少,在即使只有1个核的机器上也可以创建出成千上万个进程,CPU不可能同时执行这么多的进程,因此必然存在这样的进程,即使其一切准备就绪也不能被分配到计算资源,这样的进程就被放到了就绪队列。
现在进程B就位于就绪队列,万事俱备只欠CPU,如图所示:

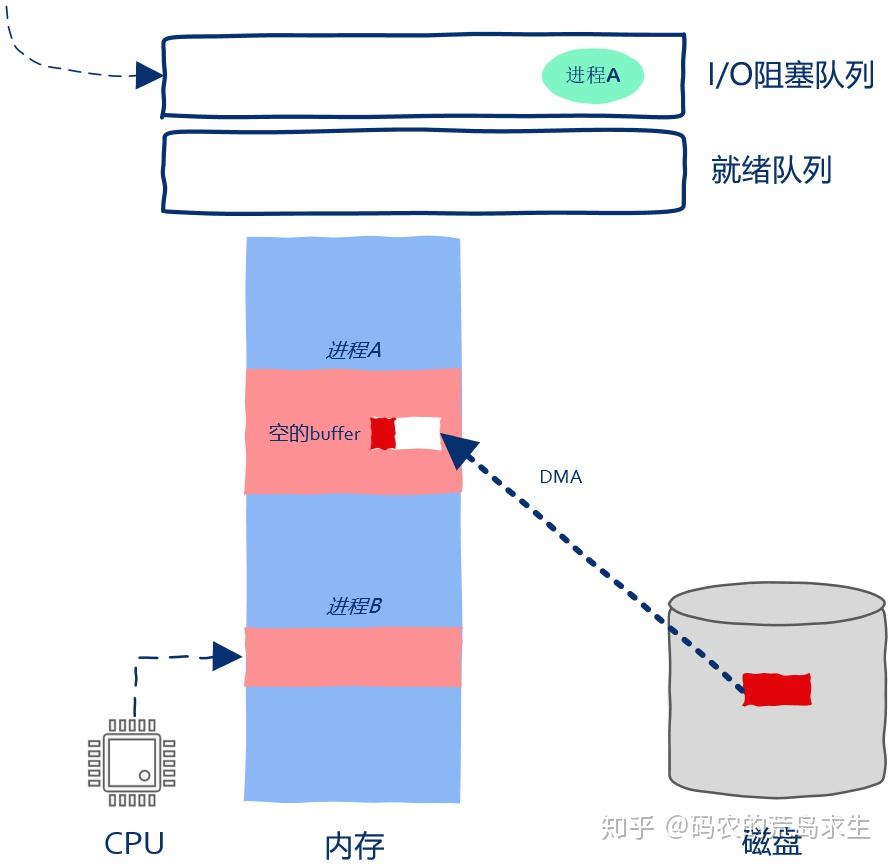
当进程A被暂停执行后CPU是不可以闲下来的,因为就绪队列中还有嗷嗷待哺的进程B,这时操作系统开始在就绪队列中找下一个可以执行的进程,也就是这里的进程B。
此时操作系统将进程B从就绪队列中取出,找出进程B被暂停时执行到的机器指令的位置,然后将CPU的PC寄存器指向该位置,这样进程B就开始运行啦,如图所示:


注意,注意,接下来的这段是重点中的重点。
注意观察上图,此时进程B在被CPU执行,磁盘在向进程A的内存空间中copy数据,看出来了吗,大家都在忙,谁都没有闲着,数据copy和指令执行在同时进行,在操作系统的调度下,CPU、磁盘都得到了充分的利用,这就是程序员的智慧所在。
现在你应该理解为什么操作系统这么重要了吧。
此后磁盘终于将全部数据都copy到了进程A的内存中,这时磁盘通知操作系统任务完成啦,你可能会问怎么通知呢?这就是中断。
操作系统接收到磁盘中断后发现数据copy完毕,进程A重新获得继续运行的资格,这时操作系统小心翼翼的把进程A从阻塞队列放到了就绪队列当中,如图所示:

注意,从前面关于就绪状态的讨论中我们知道,操作系统是不会直接运行进程A的,进程A必须被放到就绪队列中等待,这样对大家都公平。
此后进程B继续执行,进程A继续等待,进程B执行了一会儿后操作系统认为进程B执行的时间够长了,因此把进程B放到就绪队列,把进程A取出并继续执行。
注意操作系统把进程B放到的是就绪队列,因此进程B被暂停运行仅仅是因为时间片到了而不是因为发起I/O请求被阻塞,如图所示:


进程A继续执行,此时buff中已经装满了想要的数据,进程A就这样愉快的运行下去了,就好像从来没有被暂停过一样,进程对于自己被暂停一事一无所知,这就是操作系统的魔法
现在你应该明白了I/O是一个怎样的过程了吧。
这种进程执行I/O操作被阻塞暂停执行的方式被称为阻塞式I/O,blocking I/O,这也是最常见最容易理解的I/O方式,有阻塞式I/O就有非阻塞式I/O,在这里我们暂时先不考虑这种方式。
在本节开头我们说过暂时只考虑进程而不考虑线程,现在我们放宽这个条件,实际上也非常简单,只需要把前图中调度的进程改为线程就可以了,这里的讨论对于线程一样成立。
零拷贝,Zero-copy
最后需要注意的一点就是上面的讲解中我们直接把磁盘数据copy到了进程空间中,但实际上一般情况下I/O数据是要首先copy到操作系统内部,然后操作系统再copy到进程空间中。因此我们可以看到这里其实还有一层经过操作系统的copy,对于性能要求很高的场景其实也是可以绕过操作系统直接进行数据copy的,这也是本文描述的场景,这种绕过操作系统直接进行数据copy的技术被称为Zero-copy,也就零拷贝,高并发、高性能场景下常用的一种技术,原理上很简单吧。
总结
本文讲解的是程序员常用的I/O,一般来说作为程序员我们无需关心,但是理解I/O背后的底层原理对于设计高性能、高并发系统是极为有益的,希望这篇能对大家加深对I/O的认识有所帮助。


 楼主| 智慧谋略 发表于 2024-3-12 12:28:56 | 显示全部楼层
高并发中又一关键技术,即I/O多路复用,在讲解该技术之前,我们需要预习一下文件以及文件描述符。什么是文件
程序员使用I/O最终都逃不过文件。
因为这篇同属于高性能、高并发系列,讲到高性能、高并发就离不开Linux/Unix,因此这里就来讨论一下Linux世界中的文件。
实际上对于程序员来说文件是一个很简单的概念,我们只需要将其理解为一个N byte的序列就可以了:
b1, b2, b3, b4, ....... bN
实际上所有的I/O设备都被抽象为了文件这个概念,一切皆文件,Everything isFile,磁盘、网络数据、终端,甚至进程间通信工具管道pipe等都被当做文件对待。
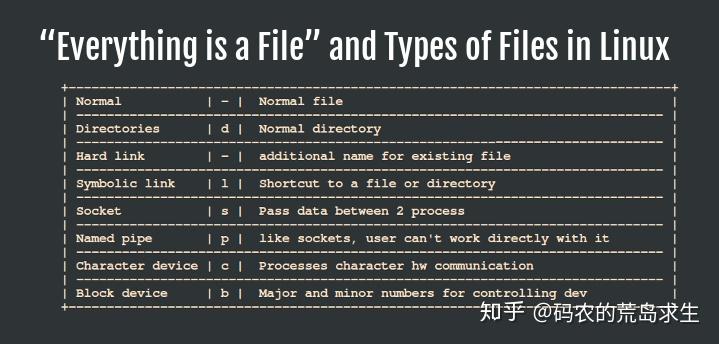
所有的I/O操作也都是通过文件读写来实现的,这一非常优雅的抽象可以让程序员使用一套接口就能实现所有I/O操作
常用的I/O操作接口一般有以下几类:
  • 打开文件,open
  • 改变读写位置,seek
  • 文件读写,read、write
  • 关闭文件,close
程序员通过这几个接口几乎可以实现所有I/O操作,这就是文件这个概念的强大之处。
文件描述符
在本篇第二节I/O过程中我们讲到,要想读取比如磁盘数据我们需要指定一个buff用来装入数据,是这样用的:
  1. read(buff);
复制代码
但是这里我们忽略了一个问题,那就是虽然我们执行了往哪里写数据,但是我们该从哪里读数据呢?
通过文件这个概念我们能实现几乎所有I/O操作,因此这里少的一个主角就是文件
那么我们一般都这么使用文件呢?
如果你周末去比较火的餐厅吃饭应该会有体会,一般周末这样的餐厅都会排队,然后服务员会给你一个排队序号,通过这个序号服务员就能找到你,这里的好处就是服务员无需记住你是谁、你的名字是什么、是不是保护环境爱好小动物等等,这里的关键点就是服务员对你一无所知,但是依然可以通过一个号码就能找到你
同样的,在Linux世界使用文件,我们也需要借助一个号码,根据“弄不懂原则”,这个号码就被称为了文件描述符file descriptors,在Linux世界中鼎鼎大名,其道理和上面那个排队号码一样。
因此,文件描述仅仅就是一个数字而已,但是通过这个数字我们可以操作一个打开的文件,这一点要记住。
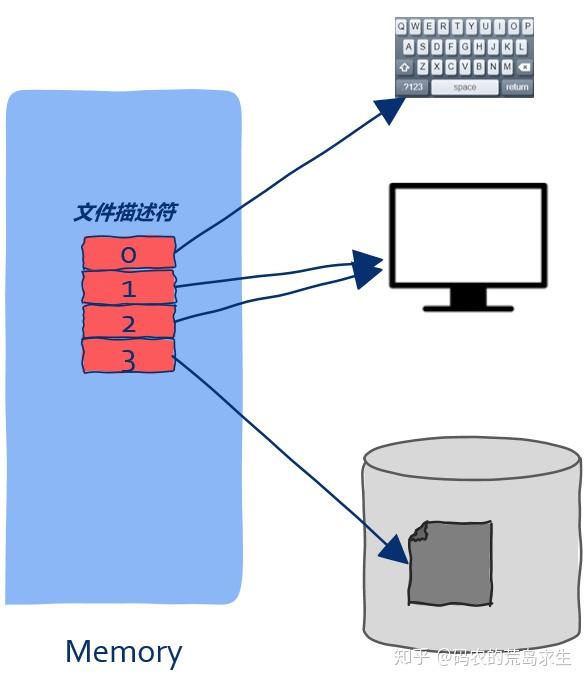
有了文件描述符,进程对文件一无所知,比如文件在磁盘的什么位置上、内存是如何管理文件的等等,这些信息属于操作系统,进程无需关心,操作系统只需要给进程一个文件描述符就足够了。
因此我们来完善上述程序:
  1. int fd = open(file_name);
  2. read(fd, buff);
复制代码

怎么样,是不是非常简单。
文件描述符太多了怎么办
经过了这么多的铺垫,终于到高性能、高并发这一主题了。
从前几节我们知道,所有I/O操作都可以通过文件样的概念来进行,这当然包括网络通信。
如果你是一个web服务器,当三次握手成功以后,我们通过调用accept同样会得到一个文件描述符,只不过这个文件描述符是用来进行网络通信的,通过读写该文件描述符你就可以同客户端通信。在这里为了概念上好理解,我们称之为链接描述符,通过这个描述符我们就可以读写客户端的数据了。


  1. int conn_fd = accept(...);
复制代码

server的处理逻辑通常是读取客户端请求数据,然后执行某些特定逻辑:
  1. if(read(conn_fd, request_buff) > 0) {
  2.     do_something(request_buff);
  3. }
复制代码

是不是非常简单,然而世界终归是复杂的,也不是这么简单的。
接下来就是比较复杂的了。
既然我们的主题是高并发,那么server端就不可能只和一个客户端通信,而是成千上万个客户端。这时你需要处理不再是一个描述符这么简单,而是有可能要处理成千上万个描述符。
为了不让问题一上来就过于复杂,我们先简单化,假设只同时处理两个客户端的请求。
有的同学可能会说,这还不简单,这样写不就行了:

  1. if(read(socket_fd1, buff) > 0) { // 处理第一个
  2.     do_something();
  3. }
  4. if(read(socket_fd2, buff) > 0) {
  5.     do_something();
复制代码

在本篇第二节中我们讨论过这是非常典型的阻塞式I/O,如果读取第一个请求进程被阻塞而暂停运行,那么这时我们就无法处理第二个请求了,即使第二个请求的数据已经就位,这也就意味着所有其它客户端必须等待,而且通常情况下也不会只有两个客户端而是成千上万个,上万个连接也要这样串行处理吗。
聪明的你一定会想到使用多线程,为每个请求开启一个线程,这样一个线程被阻塞不会影响到其它线程了,注意,既然是高并发,那么我们要为成千上万个请求开启成千上万个线程吗,大量创建销毁线程会严重影响系统性能。
那么这个问题该怎么解决呢?
这里的关键点在于在进行I/O时,我们并不是到该文件描述对于的I/O设备是否是可读的、是否是可写的,在外设的不可读或不可写的状态下进行I/O只会导致进程阻塞被暂停运行。
因此要优雅的解决这个问题,就要从其它角度来思考这个问题了。
不要打电话给我,有需要我会打给你
大家生活中肯定会接到过推销电话,而且不止一个,一天下来接上十个八个推销电话你的身体会被掏空的。
这个场景的关键点在于打电话的人并不知道你是不是要买东西,只能来一遍遍问你,因此一种更好的策略是不要让他们打电话给你,记下他们的电话,有需要的话打给他们。
也就是不要打电话给我,有需要我会打给你
在这个例子中,你,就好比内核,推销者就好比应用程序,电话号码就好比文件描述符,和你用电话沟通就好比I/O。
现在你应该明白了吧,处理多个文件描述符的更好方法其实就存在于推销电话中。
因此相比上一节中我们主动通过I/O接口主动问内核这些文件描述符对应的外设是不是已经就绪了,一种更好的方法是,我们把这些内核一股脑扔给内核,并霸气的告诉内核:“我这里有1万个文件描述符,你替我监视着它们,有可以读写的文件描述符时你就告诉我,我好处理”。而不是弱弱的问内核:“第一个文件描述可以读写了吗?第二个文件描述符可以读写吗?第三个文件描述符可以读写了吗?”
这样应用程序就从“繁忙”的主动变为清闲的被动了,反正哪些设备ok了内核会通知我, 能偷懒我才不要那么勤奋。


这是一种不同的处理I/O的机制,同样需要起一个名字,再次祭出“弄不懂原则”,就叫I/O多路复用吧,这就是 I/O multiplexing。
I/O多路复用,I/O multiplexing
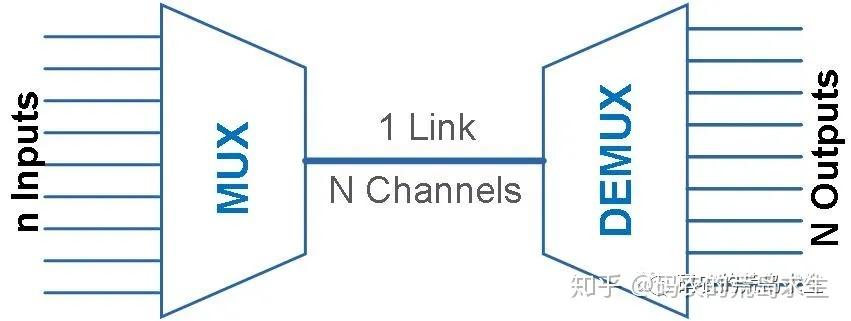
multiplexing一词其实多用于通信领域,为了充分利用通信线路,希望在一个信道中传输多路信号,要想在一个信道中传输多路信号就需要把这多路信号结合为一路,将多路信号组合成一个信号的设备被称为multiplexer,显然接收方接收到这一路组合后的信号后要恢复原先的多路信号,这个设备被称为demultiplexer,如图所示:
回到我们的主题。
所谓I/O多路复用指的是这样一个过程:
  • 我们拿到了一堆文件描述符(不管是网络相关的、还是磁盘文件相关等等,任何文件描述符都可以)
  • 通过调用某个函数告诉内核:“这个函数你先不要返回,你替我监视着这些描述符,当这堆文件描述符中有可以进行I/O读写操作的时候你再返回
  • 当调用的这个函数返回后我们就能知道哪些文件描述符可以进行I/O操作了。
那么有哪些函数可以用来进行I/O多路复用呢?
在Linux世界中有这样三种机制可以用来进行I/O多路复用:
  • select
  • poll
  • epoll
接下来我们就简单介绍一下牛掰的I/O多路复用三剑客。


I/O多路复用三剑客
本质上select、poll、epoll都是阻塞式I/O,也就是我们常说的同步I/O。
select:初出茅庐
在select这种I/O多路复用机制下,我们需要把想监控的文件描述集合通过函数参数的形式告诉select,然后select会将这些文件描述符集合拷贝到内核中,我们知道数据拷贝是有性能损耗的,因此为了减少这种数据拷贝带来的性能损耗,Linux内核对集合的大小做了限制,并规定用户监控的文件描述集合不能超过1024个,同时当select返回后我们仅仅能知道有些文件描述符可以读写了,但是我们不知道是哪一个,因此程序员必须再遍历一边找到具体是哪个文件描述符可以读写了。
因此,总结下来select有这样几个特点:
  • 我能照看的文件描述符数量有限,不能超过1024个
  • 用户给我的文件描述符需要拷贝的内核中
  • 我只能告诉你有文件描述符满足要求了,但是我不知道是哪个,你自己一个一个去找吧(遍历)
因此我们可以看到,select机制的特性在高性能网络服务器动辄几万几十万并发链接的场景下无疑是低效的。
poll:小有所成
poll和select是非常相似的,poll相对于select的优化仅仅在于解决了文件描述符不能超过1024个的限制,select和poll都会随着监控的文件描述增加而出现性能下降,因此不适合高并发场景。
epoll:独步天下
在select面临的三个问题中,文件描述数量限制已经在poll中解决了,剩下的两个问题呢?
针对第一个epoll使用的策略是各个击破共享内存
实际上文件描述符集合变化的频率比较低,select和poll频繁的拷贝整个集合,内核都快要烦死了,epoll通过引入epoll_ctl很体贴的做到了只操作那些有变化的文件描述符,同时epoll和内核还成为了好朋友,共享了同一块内存,这块内存中保存的就是那些已经可读或者可写的的文件描述符集合,这样就减少了内核和程序的内存拷贝开销。
针对第二点,epoll使用的策略是“当小弟”。
在select和poll机制下,进程要亲自下场去各个文件描述符上等待,任何一个文件描述可读或者可写就唤醒进程,但是进程被唤醒后也是一脸懵逼并不知道到底是哪个文件描述符可读或可写,还要再从头到尾检查一遍。
但epoll就懂事多了,主动找到进程要当小弟替大哥出头。
在这种机制下,进程不需要亲自下场了,进程只要等待在epoll上,epoll代替进程去各个文件描述符上等待,当哪个文件描述符可读或者可写的时候就告诉epoll,epoll用小本本认真记录下来然后唤醒大哥:“进程大哥,快醒醒,你要处理的文件描述符我都记下来了”,这样进程被唤醒后就无需自己从头到尾检查一遍,因为epoll都已经记下来了。
因此我们可以看到,在这种机制下,实际上利用的就是“不要打电话给我,有需要我会打给你”,这就不需要一遍一遍像孙子一样问各个文件描述符了,而是翻身做主人当大爷了,“你们那个文件描述符可读或者可写了主动报上来”,这中机制实际上就是大名鼎鼎的事件驱动,event-driven,这也是我们下一篇的主题。
实际上在Linux平台,epoll基本上就是高并发的代名词
限于篇幅,关于epoll的详细使用方法就不在这里讲解了。
总结
基于一切皆文件的设计哲学,I/O也可以通过文件的形式实现,显然高并发要与多个文件交互,这就离不开高效的I/O多路复用技术,本文我们详细讲解了什么是I/O多路复用以及使用方法,这其中以epoll为代表的I/O多路复用(基于事件驱动)技术使用非常广泛,实际上你会发现但凡涉及到高并发、高性能都能见到事件驱动的编程方法,这也是下一篇的主题。

高级模式
B Color Image Link Quote Code Smilies

本版积分规则

Archiver|手机版|小黑屋|探索掌握未知、共创美好未来

GMT+8, 2026-9-17 02:30 , Processed in 0.083773 second(s), 44 queries .

Powered by Discuz! X5.0

© 2001-2026 Discuz! Team.

快速回复 返回顶部 返回列表