找回密码
 立即注册
搜索

[硬件] CISC & RISC:从何而来,何至于此

[复制链接]
智慧谋略 发表于 2024-10-2 07:00:21 | 显示全部楼层 |阅读模式
这个专栏我会带你学习计算机基础。什么是基础?
基础就是根,从哪里来,到哪里去。而学习计算机基础,首先就要把握它的历史,这样才能了解计算机是怎么一步步发展到今天这个样子的,再根据今天的状况推导出未来的发展方向。
正所谓读历史方知进退,明兴衰。人类比其它动物高级的原因,就是人类能使用和发现工具。从石器时代到青铜器时代,再到铁器时代,都是工具种类和材料的发展,推动了文明升级。
让我们先从最古老的算盘开始聊起,接着了解一下机械计算机、图灵机和电子计算机。最后我会带你一起看看芯片的发展,尤其是它的两种设计结构——CISC与RISC。
从算盘到机械计算机
算盘就是一种辅助计算的工具,由中国古代劳动人民发明,迄今已有两千多年的历史,一直沿用至今。我准备了算盘的平面草图,你可以感受一下:
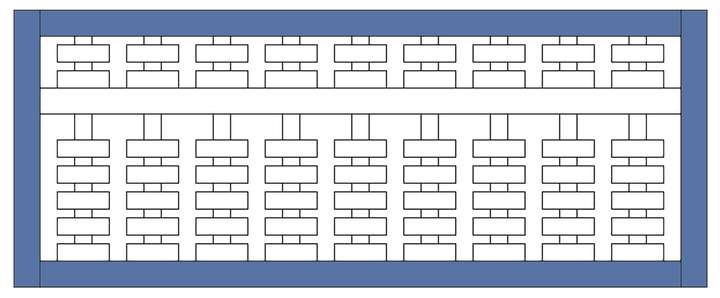
上图中周围一圈蓝色的是框架,一串一串的是算椽和算珠,一根算椽上有七颗算珠,可以上下拨动,从右至左有个、十、百……亿等计数位。有了算盘,计算的准确性和速度得到提高,我们从中可以感受到先辈的智慧。
与其说算盘是计算机,还不如说它是个数据寄存器。“程序”的执行需要人工实现,按口诀拨动算珠。过了两千多年,人们开始思考,能不能有一种机器,不需要人实时操作就能自动完成一些计算呢?16世纪,苏格兰人John Napier发表了论文,提到他发明了一种精巧设备,可以进行四则运算和解决方根运算。之后到了18世纪,英国人Babbage设计了一台通用分析机。这期间还出现了计算尺等机械计算设备,主要是利用轴、杠杆、齿轮等机械部件来做计算。尤其是Babbage设计的分析机,设计理论非常超前,既有保存1000个50位数的“齿轮式储存室”,用于运算的“运算室”,还有发送和读取数据的部件以及负责在“存储室”、“运算室”运算运输数据的部件。具体的构思细节,你有兴趣可以自行搜索资料探索。一个多世纪之后,现代电脑的结构几乎是Babbage分析机的翻版,无非是主要部件替换成了大规模集成电路。仅此一点,Babbage作为计算机系统设计的“开山鼻祖”,就当之无愧。值得一提的是,Babbage设计分析机的过程里,遇到了一位得力女助手——Ada。虽说两人的故事无从考证,但Ada的功劳值得铭记,她是为分析机编写程序(计算三角函数的程序、伯努利函数程序等)的第一人,也是公认的世界上第一位软件工程师。又过了一个世纪,据说美国国防部花了十年光阴,才把开发军事产品所需的全部软件功能,都归纳整理到了一种计算机语言上,期待它成为军方千种计算机的标准。1981年,这种语言被正式命名为ADA语言。
可惜的是,这种分析机需要非常高的机械工程制造技术,后来政府停止了对他们的支持。尽管二人后来贫困潦倒,Ada也在36岁就英年早逝,但这两个人的思想和为计算机发展作出的贡献,足以彪炳史册,流芳百世。
图灵机机械计算机有很多缺点,比如难于制造,难于维护,计算速度太慢,理论不成熟等。这些难题导致用机械计算机做通用计算的话,并不可取。而真正奠定现代通用计算机理论的人,在20世纪初横空出世,他就是图灵,图灵奖就是用他名字命名的。
图灵在计算可行性和人工智能领域贡献卓越,最重要的就是提出了图灵机。
图灵机的概念是怎么来的呢?图灵在他的《论可计算数及其在判定问题中的应用》一文中,全面分析了人的计算过程。他把计算提炼成最简单、基本、确定的动作,然后提出了一种简单的方法,用来描述机械性的计算程序,让任何程序都能对应上这些动作。
该方法以一个抽象自动机概念为基础,不但定义了什么“计算”,还首次将计算和自动机联系起来。这对后世影响巨大,而这种“自动机”后来就被我们称为“图灵机”。
图灵机是一个抽象的自动机数学模型,它是这样运转的:有一条无限长的纸带,纸带上有无限个小格子,小格子中写有相关的信息。纸带上有一个读头,读头能根据纸带小格子里的信息做相关的操作,并且能来回移动。如果你感觉文字叙述还不够形象,我再来画一幅示意图:
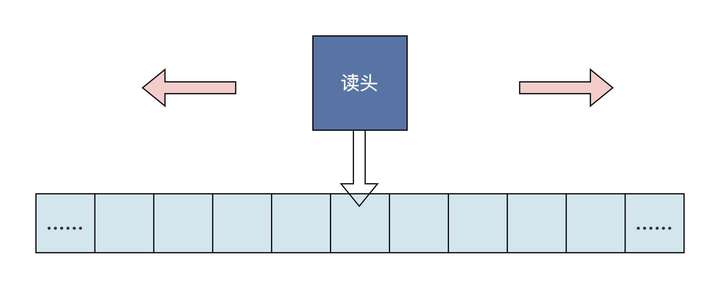
我们不妨想象一下,把自己写的一条条代码,放入上图纸带的格子中,随着读头的读取代码做相应的动作。读头移动到哪一个,就会读取哪一格的代码,然后执行相应的顺序、跳转、循环动作,完成相应计算工作。如果我们把读头及读头的运行规则理解为CPU,把纸带解释为内存,把纸带上信息理解为程序和数据,那这个模型就非常接近现代计算机了。在我看来,以最简单的方法抽象出统一的计算模型,这就是图灵的伟大之处。电子计算机图灵机这种美好的抽象模型,如果没有好的实施方案,是做不出实际产品的,这将是一个巨大的遗憾。为此,人类进行了多次探索,可惜都没有结果。最后还是要感谢弗莱明和福雷斯特,尽管他们一个是英国人,一个是美国人。这两个人本来没什么交集,不过后来弗雷斯特在弗莱明的真空二极管里,加上了一个电极(一种栅栏式的金属网,形成电子管的第三个极),就获得了可以放大电流的新器件,他把这个新器件命名为三极管,也叫真空三极管。这个三极管提高了弗莱明的真空二极管的检波灵敏度。不过,一个三极管虽然做不了计算机,但是许多个三极管组合起来形成的数字电路,就能够实现布尔代数中的逻辑运算,电子计算机的大门自此打开。
1946年,ENIAC成功研制,它诞生于美国宾夕法尼亚大学,是世界上第一台真正意义上的电子计算机。
ENIAC占地面积约170平方米,估计你在城里的房子也放不下这台机器。它有多达30个操作台,重达30吨,耗电量150千瓦。
别说屋子里放不下,电费咱们也花不起。这台机器包含了17468根电子管和7200根晶体二极管,1500个继电器,6000多个开关等许多其它电子元件,计算速度是每秒5000次加法或者400次乘法,大约是人工计算速度的20万倍。
但是三极管也不是完美的,因为三极管的内部封装在一个抽成真空的玻璃管中,这种方案在当时是非常高级的,但是仍然不可靠,用不了多久就会坏掉了。电子计算机一般用一万多根三极管,坏了其中一根,查找和维护都极为困难。
直到1947年12月,美国贝尔实验室的肖克利、巴丁和布拉顿组成的研究小组,研制出了晶体管,问题才得以解决。现在我们常说的晶体管通常指的是晶体三极管。
晶体三极管跟真空三极管功能一样,不过制造材料是半导体。它的特点在于响应速度快,准确性高,稳定性好,不易损坏。关键它可以做得非常小,一块集成电路即可容纳十几亿到几十亿个晶体管。
这样的器件用来做计算机就是天生的好材料。可以说,晶体管是后来几十年电子计算机飞速发展的基础。没有晶体管,我们简直不敢想像,计算机能做成今天这个样子。具体是如何做的呢?我们接着往下看。
芯片
让我们加点速,迈入芯片时代。我们不要一提到芯片,就只想到CPU。
CPU确实也是芯片中的一种,但芯片是所有半导体元器件的统称,它是把一定数量的常用电子元件(如电阻、电容、晶体管等),以及这些元件之间的连线,通过半导体工艺集成在一起的、具有特定功能的电路。你也可以把芯片想成集成电路。
那芯片是如何实现集成功能的呢?
20世纪60年代,人们把硅提纯,切成硅片。想实现具备一定功能的电路,离不开晶体管、电阻、电容等元件及它们之间的连接导线,把这些集成到硅片上,再经过测试、封装,就成了最终的产品——芯片。相关的制造工艺(氧化、光刻、粒子注入等)极其复杂,是人类的制造极限。
正因为出现了集成电路,原先占地广、重量大的庞然大物才能集成于“方寸之间”。而且性能高出数万倍,功耗缩小数千倍。随着制造工艺的升级,现在指甲大小的晶片上集成数十亿个晶体管,甚至在一块晶片上集成了CPU、GPU、NPU和内部总线等,每秒钟可进行上10万亿次操作。在集成电路发展初期,这样的这样的性能是不可想像的。
下面我们看看芯片中的特例——CPU,它里面包括了控制部件和运算部件,即中央处理器。1971年,Intel将运算器和控制器集成在一个芯片上,称为4004微处理器,这标志着CPU的诞生。到了1978年,开发的8086处理器奠定了X86指令集架构。此后,8086系列处理器被广泛应用于个人计算机以及高性能服务器中。
那CPU是怎样运行的呢?CPU的工作流程分为以下 5 个阶段:取指令、指令译码、执行指令、访存读取数据和结果写回。指令和数据统一存储在内存中,数据与指令需要从统一的存储空间中存取,经由共同的总线传输,无法并行读取数据和指令。这就是大名鼎鼎的冯诺依曼体系结构。
CPU运行程序会循环执行上述五个阶段,它既是程序指令的执行者,又被程序中相关的指令所驱动,最后实现了相关的计算功能。这些功能再组合成相应算法,然后由多种算法共同实现功能强大的软件。
既然CPU的工作离不开指令,指令集架构就显得尤其重要了。
CISC
从前面的内容中,我们已经得知CPU就是不断地执行指令,来实现程序的执行,最后实现相应的功能。但是一颗CPU能实现多少条指令,每条指令完成多少功能,却是值得细细考量的问题。
显然,CPU的指令集越丰富、每个指令完成的功能越多,为该CPU编写程序就越容易,因为每一项简单或复杂的任务都有一条对应的指令,不需要软件开发人员写大量的指令。这就是复杂指令集计算机体系结构——CISC。
CISC的典型代表就是x86体系架构,x86 CPU中包含大量复杂指令集,比如串操作指令、循环控制指令、进程任务切换指令等,还有一些数据传输指令和数据运算指令,它们包含了丰富的内存寻址操作。
有了这些指令,工程师们编写汇编程序的工作量大大降低。CISC的优势在于,用少量的指令就能实现非常多的功能,程序自身大小也会下降,减少内存空间的占用。但凡事有利就有弊,这些复杂指令集,包含的指令数量多而且功能复杂。
而想实现这些复杂指令,离不开CPU运算单元和控制单元的电路,硬件工程师要想设计制造这样的电路,难度非常高。
到了20世纪80年代,各种高级编程语言的出现,大大简化了程序的开发难度。
高级语言编写的代码所对应的语言编译器,很容易就能编译生成对应的CPU指令,而且它们生成的多条简单指令,跟原先CICS里复杂指令完成的功能等价。因此,那些功能多样的复杂指令光环逐渐黯淡。
说到这里,你应该也发现了,在CPU发展初期,CISC体系设计是合理的,设计大量功能复杂的指令是为了降低程序员的开发难度。因为那个时代,开发软件只能用汇编或者机器语言,这等同于用硬件电路设计帮了软件工程师的忙。
随着软硬件技术的进步,CISC的局限越来越突出,因此开始出现了与CISC相反的设计。是什么设计呢?我们继续往下看。
RISC
每个时代都有每个时代的产物。
20世纪80年代,编译器技术的发展,导致各种高级编程语言盛行。这些高级语言编译器生成的低级代码,比程序员手写的低级代码高效得多,使用的也是常用的几十条指令。
前面我说过,文明的发展离不开工具的种类与材料升级。指令集的发展,我们也可以照这个思路推演。芯片生产工艺升级之后,人们在CPU上可以实现高速缓存、指令预取、分支预测、指令流水线等部件。
不过,这些部件的加入引发了新问题,那些一次完成多个功能的复杂指令,执行的时候就变得捉襟见肘,困难重重。
比如,一些串操作指令同时依赖多个寄存器和内存寻址,这导致分支预测和指令流水线无法工作。另外,当时在IBM工作的John Cocke也发现,计算机80%的工作由大约20%的CPU指令来完成,这代表CISC里剩下的80%的指令都没有发挥应有的作用。
这些最终导致人们开始向CISC的反方向思考,由此产生了RISC——精简指令集计算机体系结构。正如它的名字一样,RISC设计方案非常简约,通常有20多条指令的简化指令集。每条指令长度固定,由专用的加载和储存指令用于访问内存,减少了内存寻址方式,大多数运算指令只能访问操作寄存器。而CPU中配有大量的寄存器,这些指令选取的都是工程中使用频率最高的指令。由于指令长度一致,功能单一,操作依赖于寄存器,这些特性使得CPU指令预取、分支预测、指令流水线等部件的效能大大发挥,几乎一个时钟周期能执行多条指令。
对CPU架构的设计和功能部件的实现也很友好。虽然完成某个功能要编写更多的指令,程序的大小也会适当增加,更占用内存。但是有了高级编程语言,再加上内存容量的扩充,这些已经不是问题。
RISC的代表产品是ARM和RISC-V。其实到了现在,RISC与CISC早已没有明显界限,开始互相融合了,比如ARM中加入越来越多的指令,x86 CPU通过译码器把一条指令翻译成多条内部微码,相当于精简指令。x86这种外CISC内RISC的选择,正好说明了这一点。
历史的车轮滚滚向前,留下的都是经典,历史也因此多彩而厚重,今天的课程就到这里了,我们要相信,即便自己不能改写历史,也能在历史上留下点什么。我们下一节课见,下次,我想继续跟你聊聊芯片行业的新贵RISC-V。
重点回顾
今天我们一起完成了一次“穿越之旅”,从最早的算盘、机械计算机,现代计算机雏形的图灵机,一路讲到芯片和CPU的两种指令架构集。
其实仅仅一节课的时间,很难把计算机的历史一一道来,所以我选择了那些对计算机产生和演进最关键的事件或者技术,讲给你听。我把今天的重点内容为你梳理了一张思维导图。
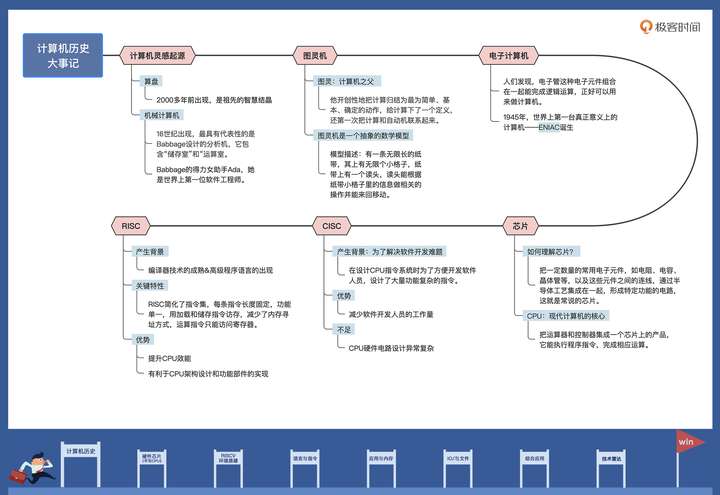
有了这些线索,你就能在脑海里大致勾勒出,计算机是如何一步步变成今天的样子。技术发展的“接力棒”现在传到了我们这代人手里,我对未来的发展充满了期待。就拿CPU的发展来说,我觉得未来的CPU可能是多种不同指令集的整合,一个CPU指令能执行多类型的指令,分别完成不同的功能。不同类型的指令由不同的CPU功能组件来执行,有的功能组件执行数字信号分析指令,有的功能组件执行图形加速指令,有的功能组件执行神经网络推算指令……
 楼主| 智慧谋略 发表于 2024-10-2 07:17:15 | 显示全部楼层
CISC 和 RISC 是 David Patterson 和 David Ditzel 在 1981 年正式提出的。四十年过去了,二者的发展有哪些融合与变迁?IT 新闻界资深人士 Joel Hruska 撰长文对该领域的发展史及其将面临的挑战做了详细阐述,以下是文章原文。
随着基于 ARM 的 M1 被推出,关于 x86 和 ARM 的比较和讨论也越来越多。这些讨论通常还涉及 CISC 和 RISC,因为「x86 与 ARM」和「CISC 与 RISC」之间的非常紧密。
但这种关联造成了一种误解:「x86 与 ARM 可以被对应归类为 CISC 与 RISC,其中 x86 是 CISC,ARM 是 RISC」,三十年前的确是这样,但现在已经不是了。
人们经常将 x86 CPU 与其他公司制造的处理器进行比较,但近二十年来 x86 都没有一个真正的架构竞争对手。

发展历程
RISC 是 David Patterson 和 David Ditzel 在他们 1981 年的开创性论文《The Case for a Reduced Instruction Set Computer》中创造的术语。他们根据 20 世纪 70 年代后期领域内的发展趋势以及当时 CPU 面临的扩展问题,正式提出了 RISC 这种半导体设计方法。此外,他们还提出了另一个术语「CISC(复杂指令集)」,来描述许多已经存在但不遵循 RISC 原则的 CPU 架构。
随着限制 CPU 性能的瓶颈发生改变,人们意识到需要一种新的 CPU 设计方法。原始 8086 就是遵循 CISC 设计原则的一个例子,它旨在通过将复杂性转移到硬件中,来缓解内存成本高的问题。
这种方法强调代码密度和对一个变量依次执行多个操作的某些指令。作为一种设计理念,CISC 试图最小化 CPU 执行给定任务所必需的指令数来提高性能,其指令集架构通常会提供一些专用指令。20 世纪 70 年代后期,CISC CPU 存在很多缺点。它们通常必须跨多个芯片才能实现,因为当时的超大规模集成电路(VLSI)技术无法将所有必要的组件封装到一起。实现支持大量极少用指令的复杂指令集架构需要消耗 die space,并且可实现的最大时钟速度也有限。与此同时,内存成本持续降低,代码尺寸变得不那么重要了。Patterson 和 Ditzel 认为当时 CISC CPU 仍在尝试解决代码膨胀问题,他们意识到绝大多数 CISC 指令都没有被用到。因此他们提出了一种完全不同的处理器设计方法——一个小得多的指令集 RISC,其中的指令长度固定,并且所有指令都能在单个时钟周期内完成。尽管 RISC CPU 每条指令执行的工作量比 CISC 的对应指令少了一些,但芯片设计人员通过简化处理器来弥补了这一点。
这种简化允许把晶体管的预算用来实现其他功能,例如用于一些额外的寄存器。1981 年人们设想未来可用的功能包括片上缓存、更大更快的晶体管,甚至是 pipelining 技术。RISC CPU 的目标是尽可能加快指令执行速度,提高 IPC(即每个时钟周期内执行的指令数,用于度量 CPU 的效率)。Patterson 和 Ditzel 认为,通过以这种方式重新分配资源,RISC 的性能最终将优于 CISC。
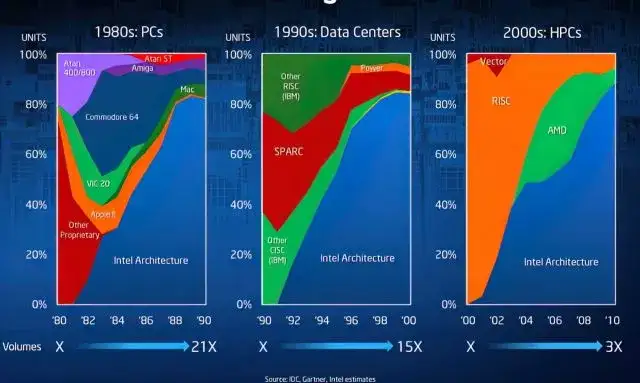
不久这种猜想就被证实。MIPS 于 1985 年推出的 R2000 在某些情况下能够维持接近 1 的 IPC。早期的 RISC CPU,例如 SPARC 和 HP 的 PA-RISC 系列,都创造了性能记录。在 20 世纪 80 年代末和 90 年代初,人们常说:「x86 等基于 CISC 的架构已经过时了,也许对于家庭计算来说足够了,但如果您想使用真正的 CPU,请购买 RISC 芯片」。以数据中心、工作站和高性能计算 (HPC) 为例:
注:此处「英特尔架构」仅指 x86 CPU,而不是 8080 等芯片,后者在早期的计算机市场上很受欢迎。此外,英特尔在 2000 年拥有许多属于「RISC」类的超级计算机,并且 x86 机器在市场上还占据较大的份额。
上图分析了 80 年代 - 00 年代 CPU 的市场状况。截止到 1990 年,在个人计算机市场,x86 占据了相当大的市场份额,非 x86 CPU 仅占约 20%;但在数据中心方面,x86 几乎没有份额,在 HPC 中也没有。当时苹果正准备设计下一代 CPU,1991 年苹果、IBM、Motorola 组成的 AIM 联盟推出了微处理器架构 PowerPC,他们相信按照 RISC 原则构建的高性能 CPU 将是计算机的未来。
CISC 与 RISC 并肩发展的历史至 20 世纪 90 年代初为止。英特尔的 x86 架构在 PC、数据中心和 HPC 等计算行业继续占据主导地位的事实是无可争议的,有争议的是:英特尔和 AMD 的 CPU 架构是否真的是采用 RISC 设计原则实现的
观点分歧
在 CPU 开发领域,一些概念和属性是长期存在分歧的。例如 Paul DeMone 曾在《RISC vs. CISC Still Matters》一文中写道:
随着使用固定长度控制字来操纵乱序执行数据路径的现代 x86 处理器的出现,RISC 和 CISC 之间的混淆变得越来越严重。「RISC 和 CISC 正在融合」是一个在根本上就存在缺陷的观点,可以追溯到 1992 年 i486 的发布。其根源在于人们对指令集架构和物理处理器实现细节之间的差异普遍无知。
相比之下,Jon Stokes 在《RISC vs. CISC: the Post-RISC Era》中说:
显然到目前为止,「RISC」和「CISC」这两种缩写术语掩盖了一个事实,即两种设计理念都不仅仅处理指令集的简单性或复杂性...... 从 RISC 和 CISC 的发展史以及两种方法试图解决的问题看,这两个术语都很荒谬…… 关于「RISC 与 CISC」的辩论早已结束,现在必须要进行一个更细致入微、更有趣的讨论,即基于硬件和软件、ISA 和实现等方面进行讨论。
然而,这些文章都过时了。Stokes 的文章写于 1999 年,DeMone 的文章写于 2000 年。这里引用他们的文章是为了说明 RISC 与 CISC 和现代计算的关联早已有 20 多年的历史。
关于实现与 ISA的两种观点
上文提到的引述反映了关于「CISC 与 RISC」的两种不同观点。DeMone 的观点与今天 ARM 和苹果的观点基本一致,这种观点被称为「以 ISA 为中心(ISA-centric position)」。
在过去几十年里,Stokes 的观点是 PC 领域的主流观点,被称为「以实现为中心(implementation-centric position)」。我使用「实现(implementation)」这个词是因为它可以在上下文中指代 CPU 的微架构或用于制造物理芯片的制程节点。
上述两种位置都以「中心(centric)」的形式描述,两种观点之间是存在交集的。即使观点不一,但都遵循一些共同的趋势。
在以 ISA 为中心的观点中,RISC 指令集的某些先天特征使其比 x86 更高效,包括使用固定长度指令和加载 / 存储设计。虽然 CISC 和 RISC 之间的一些原始差异不再有意义,但以 ISA 为中心的观点认为,就 x86 和 ARM 之间的性能和能效而言,仍然具有一些关键差异。
以 ISA 为中心的观点认为,英特尔、AMD 和 x86 胜过 MIPS、SPARC 和 POWER/PowerPC,原因有以下三个:英特尔卓越的工艺制造、英特尔的优势使所谓的「CISC tax」逐渐减少、二进制兼容性提升了 x86 的价值。
以实现为中心的观点则着眼于自 RISC、CISC 等术语出现以来现代 CPU 的发展方式,并认为这两种术语已完全过时。
例如,现在 x86 和高端 ARM CPU 都使用乱序执行来提高 CPU 的性能。而使用芯片即时重排序指令以提高执行效率的做法与 RISC 的原始设计理念完全不一致,Patterson 和 Ditzel 主张采用能够以更高时钟速度运行的不太复杂的 CPU。现代 ARM CPU 还有一些特性,例如 SIMD 执行单元和分支预测,在 1981 年也都不存在。RISC 最初的目标是让所有指令都能在一个周期内执行,大多数 ARM 指令都符合这个规则,但是 ARMv8 ISA 和 ARMv9 ISA 包含执行时间超过一个时钟周期的指令。现代 x86 CPU 也是如此。以实现为中心的观点认为:制程节点改进和微架构增强的结合使 x86 在很久以前就可以缩小与 RISC CPU 的差距,并且 ISA 级别的差异在非常低的功率范围内无关紧要。英特尔和 AMD 等都普遍支持这种观点,2014 年我曾撰写一篇题为《The final ISA showdown: Is ARM, x86, or MIPS intrinsically more power efficient?》的相关文章。
但这种观点是完全正确的吗?
RISC 和 CISC 的开发融合了吗?
以实现为中心的观点认为,CISC 和 RISC CPU 已经交互发展了几十年,从 1990 年代中期为 x86 CPU 采用「类 RISC」解码方法开始。
常见的解释是这样的:在 1990 年代初期,英特尔和其他 x86 CPU 制造商意识到未来提高 CPU 性能需要的不仅仅是更大的缓存和更快的时钟。多家公司决定投资 x86 CPU 微架构,以动态重排序他们自己的指令流来提高性能。在该过程中,原生 x86 指令被送入 x86 解码器,并在执行前转换为「类 RISC」微操作。
二十多年来业界的观点一直是如此,但最近这种观点遭到了挑战。2020 年 Erik Engheim 写道:「x86 芯片中根本没有 RISC 的内部结构,这只是一种营销策略。」他还提到了 DeMone 的故事和 P6 微架构背后的首席架构师 Bob Colwell 的一句话。
P6 微架构是第一个实现乱序执行和原生 x86 到微操作解码引擎的英特尔微架构。P6 随奔腾 Pro 发布,后来又演变出奔腾 II、奔腾 3 及更高版本。它是现代 x86 CPU 的鼻祖。因此,P6 微架构的首席架构师 Bob Colwell 有资格解释上文所述的挑战,他说:
英特尔的 x86 在「引擎的外表」下并没有 RISC 引擎。它们通过依赖于将 x86 指令映射到机器操作或复杂指令的机器操作序列的解码 / 执行的方案来实现 x86 指令集架构,然后这些操作通过微架构找到自己的方式,遵守有关数据依赖的各种规则,最终确定时序。
完成这个过程的「微操作」有 100 多比特,携带各种复杂特异的信息,不能由编译器直接生成,且不一定是单周期。但最重要的是,它们只是一种微架构技巧,而 RISC/CISC 是关于指令集架构的。微操作的想法不是受 RISC 启发的、「类 RISC」的,或者说与 RISC 完全无关。而是我们的设计团队找到了一种方法,打破了非常复杂的指令集的复杂性,也摆脱了竞争型微处理器中存在的限制。
英特尔并不是首个将 x86 前端解码器与所谓的 RISC 风格后端结合起来的 x86 CPU 制造商,被 AMD 收购的 NexGen 同样如此。NexGen 5×86 CPU 于 1994 年 3 月首次亮相,而奔腾 Pro 直到 1995 年 11 月才推出。以下是 NexGen 对其 CPU 的描述:Nx586 处理器是 NexGen 创新以及 RISC86 微架构专利的首次实现。后来该公司给出了更多实现细节:RISC86 方法动态地将 x86 指令转化为 RISC86 指令。如下图所示,Nx586 利用了 RISC 性能原理的优势。出于 RISC86 环境的限制,每个执行单元都要更小更紧凑。
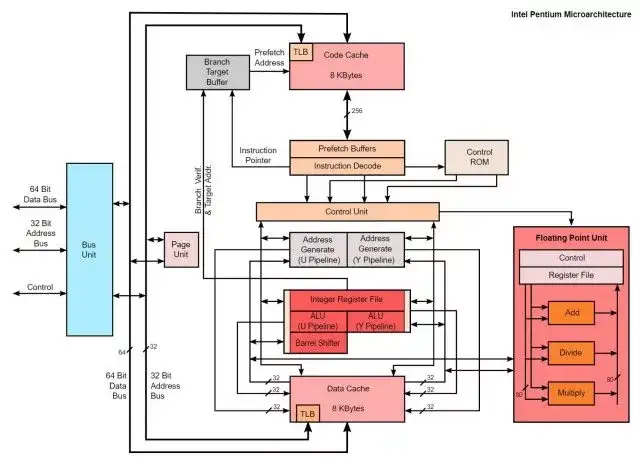
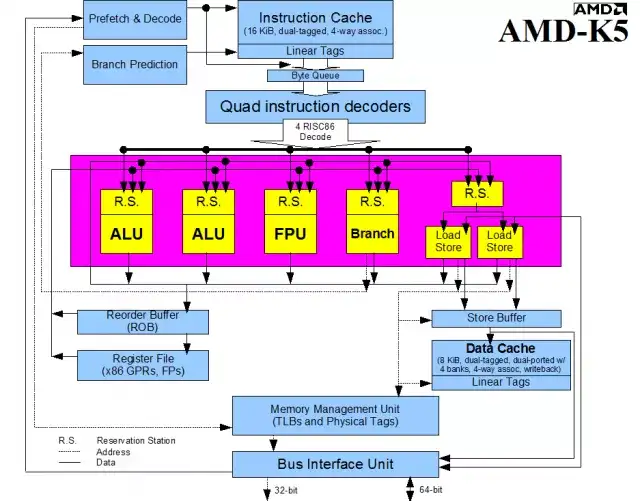
也许人们依然觉得这只是市场营销的说辞,那么让我们再来看下 1996 年的 AMD K5。K5 通常被描述为与 AMD 从其 32 位 RISC 微控制器 Am29000 借来的执行后端结和的 x86 前端。在查看它的具体框架图之前,我们首先把它与最初的英特尔奔腾比较一下。奔腾可以说是 CISC x86 进化的顶峰,因为它在 x86 CPU 中同时实现了 pipeline 和超标量设计(superscaling),但没有将 x86 指令转换为微操作,也缺乏乱序执行引擎。
AMD K5 框架图如下图所示:

如果你曾经研究过微处理器原理图,你可能会发现 K5 和微处理器有许多相似之处,但奔腾却相反。AMD 在 Nx586 上市后收购了 NexGen。K5 是 AMD 自主设计的,而 K6 最初是 NexGen 的产品。也是从那时开始,CPU 变得像今天我们熟悉的样子。设计这些芯片的工程师曾表示:这些相似之处不仅仅是表面上的。
早在 1996 年,AMD 的 David Christie 就在 IEEE Micro 上发表了一篇关于 K5 的文章,阐述了 K5 是如何将 RISC 和 CISC 结合在一起的,这里引用一段该文章的内容:
我们开发了一个松散地基于 29000 指令集的微型 ISA。一些额外的控制字段将微指令的大小扩展到 59 位。其中一些简化并加速了超标量控制逻辑,其他的用于提供特定于 x86 的功能,这些功能对于性能非常重要,因此不能用微指令序列来合成。但是这些微指令仍然遵循基本的 RISC 原则:简单的寄存器到寄存器操作,对寄存器指定符和其他字段进行固定位置编码,并且每个操作不多于一个内存引用。因此我们称它们为 RISC 操作,或简称为 ROPs。这种简单、通用的特性为实现更复杂的 x86 操作提供了灵活性,从而有利于保持执行逻辑相对简单。
RISC 微架构最关键的一点是 x86 指令集的复杂性止于解码器,并且在很大程度上对乱序执行内核是透明的。这种方法只需要很少的额外控制复杂度,而不需要乱序的 RISC 执行来实现乱序的 x86 执行。任务切换的 ROP 序列看起来并不比简单指令串的 ROP 序列复杂。执行内核的复杂性被有效地从架构的复杂性中分离出来,而不是复合起来的。
Christie 并没有混淆 ISA 与 CPU 物理实现细节之间的区别。他认为物理实现本身在一些重要的方面是 RISC 式的。K5 重用了 AMD 为其 Am29000 系列 RISC CPU 开发的执行后端部分,它实现了一个比原生 x86 ISA 更类似于 RISC 的内部指令集。在此期间,NexGen 和 AMD 引用的 RISC 式技术参考了数据缓存、pipeline 和超标量架构等参考概念。
这些想法都不是严格的 RISC,但它们都是首先在 RISC CPU 中首次亮相的,将这些功能作为「类 RISC」进行营销是有道理的。
这些功能与 RISC 的相关程度以及 x86 CPU 是否解码 RISC 样式指令,取决于选择的框架标准。这一争论比奔腾 Pro 还大,即使 P6 是与乱序执行引擎等技术发展最相关的微架构。不同公司的工程师都有自己的看法。
现代 x86 CPU 的压力
那么这种「RISC 与 CISC」比较对今天的 ARM 和 x86 CPU 有什么实际影响呢?当我们将 AMD 和英特尔 CPU 与苹果的 M1 和未来的 M2 进行比较时,我们真正要问的问题是:x86 是否存在一些瓶颈,使得其无法与苹果以及高通等公司未来的 ARM 芯片有效竞争?AMD 和英特尔给出的答案是否定的,而 ARM 给出的答案是肯定的。行业内的公司之间具有明显的利益冲突,因此我询问了丹麦计算机科学家 Agner Fog,他以其在 x86 架构和微架构方面的研究而闻名。以下是他的看法
ISA 并非无关紧要。x86 ISA 非常复杂,因为长期以来人们一直在进行小的更改和补丁,以向 ISA 中添加更多功能,而 ISA 确实已没有空间容纳此类新功能。
复杂的 x86 ISA 使解码成为瓶颈。x86 指令的长度在 1 到 15 个字节之间,计算长度非常复杂。在开始解码下一条指令之前需要知道指令的长度。如果您想每个时钟周期解码 4 或 6 条指令,这肯定是个问题!英特尔和 AMD 现在都在不断增加微操作缓存来克服这个瓶颈。而 ARM 有固定大小的指令,所以这个瓶颈不存在,也不需要微操作缓存。
x86 的另一个问题是它需要很长的管道来处理复杂性。分支误预测惩罚等于 pipeline 的长度。因此,他们正在添加越来越复杂的分支预测机制,其中包含大型分支历史信息表和分支目标缓冲区。当然,所有这些都需要更多的芯片空间和更多的功耗。
尽管有这些负担,x86 ISA 还是相当成功的。这是因为它可以为每条指令做更多的工作。
Agner 还在他的微架构手册中写道:AMD 和英特尔 CPU 设计的最新趋势已经回归到 CISC 原则,以更好地利用有限的代码缓存,增加管道带宽,并通过在 pipeline 中维持较少的微操作数量来降低功耗。这些改进代表了提高 x86 整体性能和功耗效率的微架构变迁。
那么就存在一个重要的问题:现代 AMD 和英特尔 CPU 为 x86 兼容性付出了多大的代价?
Agner 提到的解码瓶颈、分支预测和 pipeline 复杂性是 ARM 认为 x86 产生的「CISC tax」的一部分。过去,英特尔和 AMD 告诉我们解码功耗只是芯片总功耗的极小一部分。但是,如果 CPU 正在为微操作缓存或复杂的分支预测器消耗能量以弥补解码带宽的不足,那么意义就不一样了。微操作缓存功耗和分支预测功耗均由 CPU 的微架构及其制造制程节点决定。「RISC 与 CISC」并没有充分体现这三个变量之间关系的复杂性。
也许我们还需要几年的时间才能知道苹果的 M1 和高通未来的 CPU 是否代表了市场翻天覆地的变化,AMD 和英特尔是否将面临下一个挑战。保持 x86 兼容性是否是现代 CPU 的负担,这既是一个新问题,也是一个非常古老的问题。之所以说它是一个新问题是因为在 M1 推出之前,无法进行有意义的比较;说它是一个旧问题是因为当初 x86 CPU 诞生时,一些个人计算机延续使用非 x86 CPU 就让这个主题引起过相当多的讨论。
AMD 仍在以每年 1.15 至 1.2 倍的速度改进 Zen,英特尔的 Alder Lake 也将使用低功耗 x86 CPU 内核来改进功耗,两家 x86 制造商都在不断改进他们的方法。需要一些时间来观察这些内核及其后继者如何与未来的苹果产品竞争,但 x86 一直未脱离这场竞争。
回到最初那个问题:为什么用 RISC 与 CISC 比较 x86 和 ARM CPU 是错误的?
当 Patterson 和 Ditzel 创造 RISC 和 CISC 时,他们打算阐明 CPU 设计的两种不同策略。四十年过去了,这些术语既模糊又清晰。RISC 和 CISC 并非毫无意义,但这两个术语的含义和适用性已变得高度语境化。
使用 RISC 与 CISC 来比较现代 x86 和 ARM CPU,其问题在于:它需要 3 个对 x86 和 ARM 比较重要的特定属性——制程节点、微架构和 ISA——将 3 个属性结婚在一起,然后才能声明 ARM 在 ISA 的基础上更胜一筹。「以 ISA 为中心」与「以实现为中心」是一种更好的理解方式,但前提是人们需要记得两者之间的关系。具体来说:
以 ISA 为中心的观点认为制造几何(manufacturing geometry)和微架构非常重要,并且促成了 x86 在 PC、服务器和 HPC 市场曾经的主导地位。这种观点认为,当制造能力和安装基础的优势被控制或取消时,RISC(以及 ARM CPU)通常会优于 x86 CPU。
以实现为中心的观点认为 ISA 确实很重要,但从发展历程的角度看,微架构和制程几何(process geometry)更重要。当前,英特尔正在努力缩小一些业内差距,AMD 在努力改进 Ryzen(尤其是在移动领域)。但从发展历程上看,这两家 x86 制造商都表现出具备与 RISC CPU 制造商有效竞争的能力。
考虑到 CPU 设计周期的现实情况,我们还需要几年的时间才能真正得出哪个观点更好的答案。今天的半导体市场与 20 年前的市场之间有一个区别:与英特尔在 1990 年代末和 2000 年代初所面临的大多数 RISC 制造商相比,台积电是一个更强大的代工竞争对手。英特尔的 7nm 团队不得不承受巨大的压力。
RISC 与 CISC 是理解两种不同类型 CPU 之间差异的起点,而不是今天如何比较的准确依据。


 楼主| 智慧谋略 发表于 2024-10-2 07:38:49 | 显示全部楼层
现代ARM与x86架构:RISC vs. CISC的能源效率之争
在计算机架构的历史中,RISC(精简指令集)与CISC(复杂指令集)之间的竞争是20世纪80年代的一个关键议题。那时,芯片面积和处理器设计的复杂性是主要的设计限制,而桌面和服务器市场几乎被RISC和CISC两大阵营所瓜分。RISC以其高效能、低复杂度的优势在高性能计算领域占有一席之地,而CISC则通过丰富的指令集和更高的处理能力在个人电脑和服务器市场中占据主导。然而,随着技术的发展,能源效率和功率消耗已经成为当前设计的核心考虑因素。现代计算环境发生了显著变化,移动设备如平板电脑和智能手机的崛起,其中大部分采用的是ARM架构的RISC指令集,其增长速度已经超过了运行x86架构(CISC)的桌面和笔记本电脑。更值得注意的是,ARM架构正逐渐进入高性能服务器市场,而传统的高性能x86架构也开始涉足低功耗的移动设备领域。

    与以往传统不同,近年来以低功耗著称采用RISC的ARM架构芯片开始进入高性能服务器市场,而相对的,以性能著称采用CISC的x86架构芯片也开始蚕食移动端份额。在此背景之下,文章主要研究和探讨了RISC和CISC在功耗控制方面的异同。具体比对了ARM Cortex-A8 、Cortex-A9 和 Intel Atom 、Sandybridge i7 这几种微处理器在移动端、桌面端和服务器端的表现。最后结论简单的说就是:两种指令集在功耗控制和处理性能方面没有孰优孰劣之说,只是各自的芯片在平衡性能和功耗这个跷跷板游戏中采取的策略不尽相同罢了。
    文章接下来回顾了之前的研究,发现他们普遍的不足在于只比较了ARM和x86两种芯片在性能方面的差别,而对功耗的控制有意无意的忽视了。所以本文将采用严谨的方法仔细对比两种指令集的功耗之争。具体实验过程中为了控制变量,采用了相同的芯片技术(除指令架构外)、操作系统、编译系统等无关设定。文章结论说明不同的ISA与功耗和性能是无关的,真正影响它们的是处理器的微架构。这也印证了传统研究的已有结论,并且提供了更精确的数据支持。
   文章的第二部分介绍了RISC和CISC在指令构架方面的区别。主要对比了二者的format、operations和operands。作者列出了一个表格,横向是format、operations和operands三个变量,纵向前两行是RISC和CISC的特点,比如在format方面,RISC是定长而CISC是变长的,在Operations方面,RISC是单周期而CISC是多周期的,第三行总结了两种ISA造成的差异,如代码密度RISC<CISC,第四行展现了两种ISA在发展过程中趋同的趋势(比如I-指令和缓存),最后一行回答了一些经典的问题来进一步表现出二者的趋同化。
    接下来第三部分主要说明了研究过程中使用的设施、工具和环境等。试验中需要控制变量,使芯片的制程、频率、寄存器以及计算机的缓存、内存、操作系统、编译器尽可能相同(完全相同是不切实际的)。最终采用的芯片是ARM Cortex-A8 、Cortex-A9 和 Intel Atom 、Sandybridge i7,操作系统都是Linux 2.6 LTS内核,编译器是基于gcc 4.4的交叉编译工具。除了执行尽可能相同的运算量,在具体的运行过程中,实验人员保证了所有的运算都是单线程的,这保证了他们对单核的研究目的。至于平台方面,在移动端,采用了CoreMark和WebKit的标准,在桌面端,采用了SPECCPU2006套件,在服务器端,使用了lighttpd、CLucene和Database kernels,分别用于网络服务、网络索引和数据分析。然后是使用的工具,采用perf工具计量是指令执行时间(以时钟周期为依据),功耗方面连接了一个Watttsup表到电源上,用执行时的功率减去安静时的功率得到指令运行消耗的功率。由于i7采用的是32nm制程而Cortex-A8采用了65nm制程,为了抵消这个影响将他们统一到45nm制程,根据厂家的2007 ITRS表格将前者的功耗乘以1.3后者的功耗乘以0.8。当然以上的控制也会带来局限性,是最终结果不能保证完全准确。
    文章第四部分介绍了实验方法,作者列了一个表格分别介绍了如何测量指令执行时间和Inst. count、Inst. mix、Inst. length,以及计算机功率、主板功率和芯片功率的办法。得到这些数据之后,进一步介绍了性能分析的流程、如何进行功耗分析以及怎样分析这两者之间的取舍。
    第五部分通过大量的图标展现了实验数据并说明了研究结果。
    首先是性能部分:
    1、执行时间方面,在全部以i7为标准之后,发现在所有的平台上各芯片执行时间有巨大区别,其中A9是i7的5倍到102倍不等,而A8是Atom的2倍到997倍不等。这是由于A系列芯片的频率普遍低于i7和Atom。
    2、执行周期数方面,在转化为i7的标准之后,差距明显缩小,RISC系列的芯片都不多于CISC系列的2.5倍,其中A8不到Atom的1.5倍。
    3、指令数目方面,在以Atom为标准之后,结果显示不同的ISA的指令数目大体相同。综合知x86的CPI比ARM的更小:A8的CPI为3.4,A9为2.2,Atom为2.1,而i7最少为0.7。文章也说道,x86芯片的优势来自于它的微架构。
    4、指令格式方面,首先对比了ARM和x86生成的静态二进制代码大小和指令长度,发现两者的二进制代码大小基本相同,但是x86指令长度平均比ARM短25%,接着比对了指令的细分,发现不同ISA的load和store指令比例基本相同,这反映了二者在数据存取方面的一致。综合以上数据,结论是不同ISA在指令格式和mix方面没有太大区别。
     5、微架构方面,文章首先对比了A8和Atom、A9和i7在芯片架构方面的诸多不同,比如流水线深度A8是13而Atom是16+2,A9的BTB是512,而i7达到了8K~16K,尽管如此,在12个标准中,A9的执行周期不到i7的2倍,这个可能与issue width有关。接下来展示了三张图分别对比了不同芯片在branch mispredictions、 L1 data 和instruction cache misses per 1000 ARM instructions的区别,结果显示A9的miss普遍比i7要高,但是这些区别并不是由于ISA造成的,而更加有可能是芯片微架构设计不同的原因,比如x86拥有的更精确的分支预测和更大的缓存,极大地提高了它的处理性能。
     然后是功耗分析
     1、平均总功律,在以功耗最低的A8为基准转换之后,发现总体上x86比ARM更加耗电,其中Atom的功耗是A8的3倍左右,而i7的功耗是A9的20倍之多。
    2、在通过系数转换统一到1GHz,45nm制程的芯片之后,不同的情况出现了:Atom的功耗不到A8的0.6倍,而i7的功耗比A9也降到了7倍左右,而且注意到A8功耗比A9还要高29%,这表明在功耗方面,不同的优化方式的影响要大于ISA的影响。
   3、平均耗能(功率乘以时间),数据显示Atom平均耗能要少于A8,而i7 仅仅比A9多消耗少量能源。对此文章的结论是功耗和性能都是芯片设计之初所要着重考虑和取舍的,设计的不同所造成的影响相比ISA的影响要更大。
   第五部分最后讲了取舍分析
   1、功耗-性能之间的博弈,通过数据比较发现,A9相比A8在使用1.8倍功耗的情况下,取得了3.5倍的性能。i7相比Atom,在使用了10.9倍的功耗之后,达到了6.2倍的性能。这表明i7的微架构可能更加耗电。另一方面这也再一次证明了亘古不变的定理:想提高性能,那么先提高功率吧。
    2、耗能-性能之间的博弈,通过图表数据可知,不管ISA是什么,只针对功耗或者性能优化的核会有更多的能耗开支,只有平衡了功耗和性能之后的核才能有不错的表现。例外DVFS和其他微处理器技术能够提供更高的效能,比如在功耗相同的情况下,i7在2.2GHz运行时能达到A9的6倍性能。以上结果表明,真正影响效能的是芯片的微架构和设计方案。
      在以上数据和分析的基础上,文章给出了总结,回顾了研究目的和方法,并再一次明确了结论,即在现代芯片中,ISA的不同与功耗和性能的表现无关。同时文章强调,不同架构芯片比如x86和ARM在今后的发展过程中依然会调整ISA以适应未来的计算机性能和功耗的要求。

高级模式
B Color Image Link Quote Code Smilies

本版积分规则

Archiver|手机版|小黑屋|探索掌握未知、共创美好未来

GMT+8, 2026-9-17 02:30 , Processed in 0.057448 second(s), 35 queries .

Powered by Discuz! X5.0

© 2001-2026 Discuz! Team.

快速回复 返回顶部 返回列表